QUANTEN LEARNING
Mein lebendes Skriptum für Mathematik, Quanteninformation und das Wieder-Lernen
ARTMIS · QUANTEN LEARNING · LEBENDES SKRIPTUM
Worum geht es in diesem Skriptum?
Wie erschließt man sich nach fast drei Jahrzehnten erneut anspruchsvolle Mathematik und Quantenmechanik – und welche Rolle kann künstliche Intelligenz dabei spielen?
Quanten Learning ist das persönliche, laufend erweiterte Lernskriptum von Janine Wald. Es führt vom mathematischen Wiedereinstieg über Hilberträume, Qubits, Quantenmechanik und Quanteninformation bis zu Classical Shadows, Quantenalgorithmen, Fehlerkorrektur und Tensor-Netzwerken. Jeder Lernbaustein verbindet eine formal-mathematische Experten-Ebene mit einer anschaulichen Erklärung und einem kurzen Memo-Mantra als Gedächtnisstütze. Im Mittelpunkt steht nicht nur das Ergebnis, sondern der Weg zum Verständnis: mathematische Zusammenhänge nachvollziehen, eigene Wissenslücken schließen, mit KI lernen und wissenschaftliche Aussagen kritisch überprüfen.
Das Skriptum ist kein abgeschlossenes Lehrbuch, sondern ein offenes Lernprojekt. Fachliche Korrekturen, ergänzende Literatur und neue Perspektiven sind ausdrücklich willkommen.
Dies ist kein Lehrbuch aus der Perspektive einer Spezialistin. Es ist mein persönliches Lernarchiv: formal genug, um die Mathematik ernst zu nehmen; anschaulich genug, um auch nach längeren Pausen wieder einzusteigen; und offen genug, um immer weiterzuwachsen.
Version 1.0 · September 2026
Pre-Learning – Wie ich hierher kam
Dieses Quanten Learning baut auf einem Skriptum zur Funktionalanalysis der FernUniversität in Hagen auf, das ich die Chance hatte, durchzuarbeiten.
„Durcharbeiten“ bedeutet dabei ausdrücklich nicht, dass ich heute die Beweise und Übungsbeispiele selbstständig rechnen könnte. Nach mehr als 30 Jahren ist erstaunlich viel mathematische Sprache in den Hintergrund gerückt. Manche Begriffe, mit denen ich früher selbstverständlich gearbeitet habe, fühlen sich beim Wiedersehen zunächst vollkommen neu an.
Mit Unterstützung von KI bin ich dieses Skriptum noch einmal von Anfang bis Ende durchgegangen – weniger mit dem Ziel, jede Rechnung zu beherrschen, sondern um die Gedanken und Strukturen dahinter wiederzuentdecken.
Denn für mich ist theoretische Physik vielleicht die reinste Form von Philosophie – und Mathematik ihre Sprache.
Gerade aus dieser Perspektive fand ich den Aufbau der Funktionalanalysis wunderschön.
Man beginnt beinahe bei Punkten und Abständen. Daraus entstehen Vorstellungen von Nähe, offenen Mengen, Konvergenz und Vollständigkeit. Räume bekommen Normen. Funktionen werden selbst zu Objekten in Räumen. Operatoren wirken auf diesen Räumen, Funktionale lesen Informationen aus ihnen heraus. Schließlich gelangt man zu Hilbert-Räumen und Spektraltheorie – und damit zu einer mathematischen Welt, die tief in die moderne Physik hineinreicht.
Aus Punkt und Abstand entfaltet sich Schritt für Schritt eine Topologie, in der Funktionen leben können. Aus diesen Räumen entsteht schließlich jene Sprache, in der sich auch Quantenmechanik formulieren lässt.
Warum Classical Shadows mein Fokus wurden
Von diesem Basislernen aus wurde mein Weg plötzlich sehr konkret. Über die Arbeiten von Prof. Richard Küng an der Johannes Kepler Universität Linz stieß ich auf Classical Shadows – auf das von Hsin-Yuan Huang, Richard Kueng und John Preskill entwickelte Verfahren, mit dem sich aus randomisierten Messungen eine kompakte klassische Beschreibung eines unbekannten Quantenzustands gewinnen lässt.
Der Begriff „Shadows“ hat bei mir sofort etwas ausgelöst. Er erinnerte mich an ein platonisches Weltbild, das mich schon vor Jahrzehnten beschäftigt hat: Wir sehen nicht die Sache selbst, sondern Projektionen, Ausschnitte, Schatten – und versuchen daraus auf eine dahinterliegende Struktur zu schließen. Die Nähe zu Platons Höhlengleichnis ist für mich dabei eine persönliche Denkbrücke, keine physikalische Behauptung.
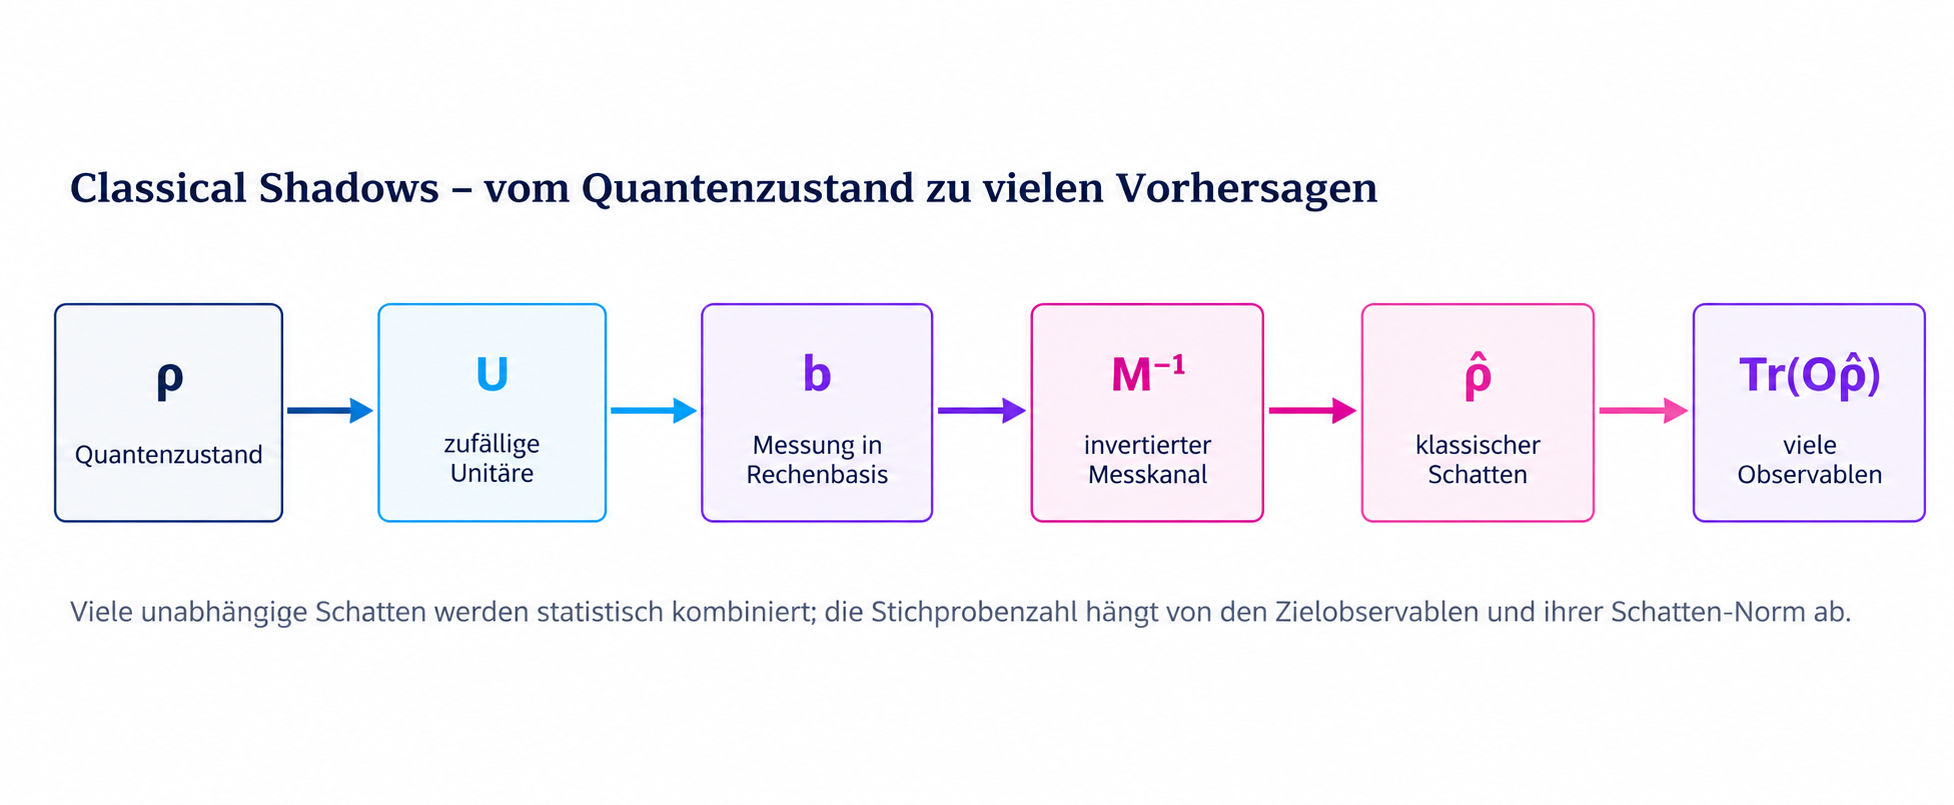
Mathematisch ist Classical Shadows viel präziser: Man nimmt wiederholt identisch präparierte Kopien eines unbekannten Quantenzustands, randomisiert die Messbasis nach einem bekannten Ensemble und speichert aus jedem Durchlauf einen klassischen „Schatten“. In diesem klar begrenzten Sinn wirkt der unbekannte Zustand für mich wie eine Blackbox: Ich kenne ρ nicht, habe aber kontrollierten Messzugriff. Das zentrale Sample-Complexity-Theorem macht den eigentlichen Trick sichtbar: Für eine feste Sammlung von M Zielobservablen wächst die nötige Zahl von Messungen – bei kontrollierter Schatten-Norm – nur logarithmisch mit M; zusätzlich bestimmen gewünschte Genauigkeit und Konfidenz den Aufwand. Man gewinnt also gezielt Information, ohne zuerst den vollständigen Zustand tomographisch rekonstruieren zu müssen.
Nicht die ganze unbekannte Quantenwelt rekonstruieren, sondern aus kontrollierten Schatten genau jene Eigenschaften herauslesen, nach denen man fragt.
Genau deshalb wurde Classical Shadows zum roten Faden dieses Skriptums. Der Hilbertraum ist für mich die Sprache, in der der Raum überhaupt erst entsteht; Classical Shadows zeigen dann, wie überraschend viel Information man aus wenigen, bewusst erzeugten Projektionen dieses Raums gewinnen kann.
Warum ich dieses Skriptum schreibe
Ich habe vor mehr als drei Jahrzehnten intensiv Mathematik gelernt. Vieles davon ist vermutlich nicht wirklich verschwunden. Aber der unmittelbare Zugriff darauf ist weg.
Bei der Cauchy-Folge hatte ich dafür ein fast absurdes Erlebnis: Der Begriff kam mir vollkommen fremd vor. Ich hätte schwören können, ihn nie zuvor gehört zu haben. Dann fand ich ihn in meinen alten mathematischen Skripten – selbstverständlich verwendet und von mir damals offenbar verstanden.
Genau deshalb gibt es dieses Quanten Learning.
Es dokumentiert meine persönliche Lernkurve zwischen Erinnern, Wiederverstehen und Neu-Lernen. Ich beginne weder bei null, noch tue ich so, als wäre das alte Wissen noch vollständig verfügbar.
KI ist dabei für mich eine neue Art von Lernbegleiter: ein geduldiger Tutor und Sparringspartner, den ich immer wieder fragen kann: Warum? Zeig mir den Zwischenschritt. Erkläre es anders. Prüfe die Rechnung. Zeichne mir das. Und jetzt noch einmal ganz einfach.
So entsteht kein Archiv einzelner Chat-Antworten, sondern ein lebendes Skriptum. Neue Gedanken sollen an bereits Verstandenes anschließen. Begriffe, die wieder verschwimmen, sollen schnell auffindbar sein. Und komplizierte Ideen sollen auf mehreren Ebenen zugänglich bleiben.
Ich teile dieses Skriptum gerne. Vielleicht weckt die eine oder andere Seite auch bei anderen die Lust, einer mathematischen oder physikalischen Frage einfach deshalb zu folgen, weil sie faszinierend ist.
Das ist für mich Vibe Learning im besten Sinn: neugierig einer Frage folgen, Verbindungen zulassen – und dort präzise werden, wo Präzision zählt.
Welche mathematischen Grundlagen braucht man, um Quantenmechanik und Quanteninformation zu verstehen?
Die Quantenmechanik verwendet eine mathematische Sprache, die auf komplexen Zahlen, linearer Algebra, Vektorräumen, Skalarprodukten, Hilberträumen und linearen Operatoren aufbaut.
Quantenzustände lassen sich als Vektoren in einem komplexen Hilbertraum beschreiben. Hermitesche Operatoren spielen bei der Darstellung physikalischer Observablen eine zentrale Rolle, während unitäre Operatoren die Zeitentwicklung geschlossener Quantensysteme beschreiben.
Für die Quanteninformation kommen weitere Konzepte hinzu: Tensorprodukte, Verschränkung, Dichtematrizen, Quantenkanäle und statistische Messverfahren. Verfahren wie Classical Shadows ermöglichen es, bestimmte Eigenschaften von Quantenzuständen aus geeigneten randomisierten Messdaten abzuschätzen, ohne den vollständigen Zustand rekonstruieren zu müssen.
Mein Quanten-Learning-Skriptum baut diese Zusammenhänge schrittweise auf. Jeder Themenbereich verbindet mathematische Definitionen mit anschaulichen Erklärungen und konkreten Rechenbeispielen.
Das Ziel ist nicht, Formeln nur anwenden zu können, sondern zu verstehen, weshalb die mathematischen Strukturen zusammenhängen – und wie sie in der Quantenphysik verwendet werden.
Die feste Struktur jedes Lernbausteins
Experten-Ebene
Formal-mathematisch: Definitionen, Notation, Zusammenhänge und
Herleitungen so präzise wie nötig.
Einfach erklärt
Dieselbe Idee noch einmal anschaulich, bildhaft und intuitiv – ohne sie dabei mathematisch falsch zu vereinfachen.
Memo-Mantra
Die Essenz als kurze Gedächtnisstütze – und wenn es sich anbietet, darf
sie sich gerne reimen.
Vorlauf 0 · Mathematischer Wiedereinstieg
Dieser Teil ist bewusst kein vollständiger Analysis- oder Lineare-Algebra-Kurs. Er reaktiviert genau die Begriffe, die im weiteren Skriptum ständig wieder auftauchen.
0.1 Komplexes Skalarprodukt

Experten-Ebene
Im Standard-Hilbertraum ℂⁿ verwenden wir die Physik-Konvention ⟨x|y⟩ = x†y = Σₖ x̄ₖ yₖ. Das Skalarprodukt ist konjugiert-linear im ersten und linear im zweiten Argument, hermitesch symmetrisch und positiv definit. Die Norm ist ||x|| = √⟨x|x⟩.
Einfach erklärt
Links wird komplex konjugiert, rechts wird normal multipliziert. Das sorgt dafür, dass die „Länge zum Quadrat“ eines Vektors immer eine nichtnegative reelle Zahl ist.

Memo-Mantra
Links wird konjugiert, rechts linear geführt – so bleibt die Norm positiv und unberührt.
0.2 Cauchy-Folge & Vollständigkeit
Experten-Ebene
Eine Folge (xₙ) heißt Cauchy-Folge, wenn zu jedem ε>0 ein N existiert, sodass ||xₙ−xₘ||<ε für alle n,m≥N gilt. Ein Hilbertraum ist ein Skalarproduktraum, der bezüglich der induzierten Norm vollständig ist: Jede Cauchy-Folge besitzt einen Grenzwert im Raum. Endlichdimensionale Räume ℂⁿ sind automatisch vollständig.
Einfach erklärt
Eine Cauchy-Folge bedeutet: Ab einem gewissen Punkt liegen die Folgenglieder beliebig nahe beieinander. „Vollständig“ heißt: Dieser Annäherungsprozess fällt nicht durch ein Loch – der Grenzwert gehört wieder zum Raum.
Memo-Mantra
Rückt die Folge immer enger ein, muss ihr Grenzwert im Hilbertraum sein.
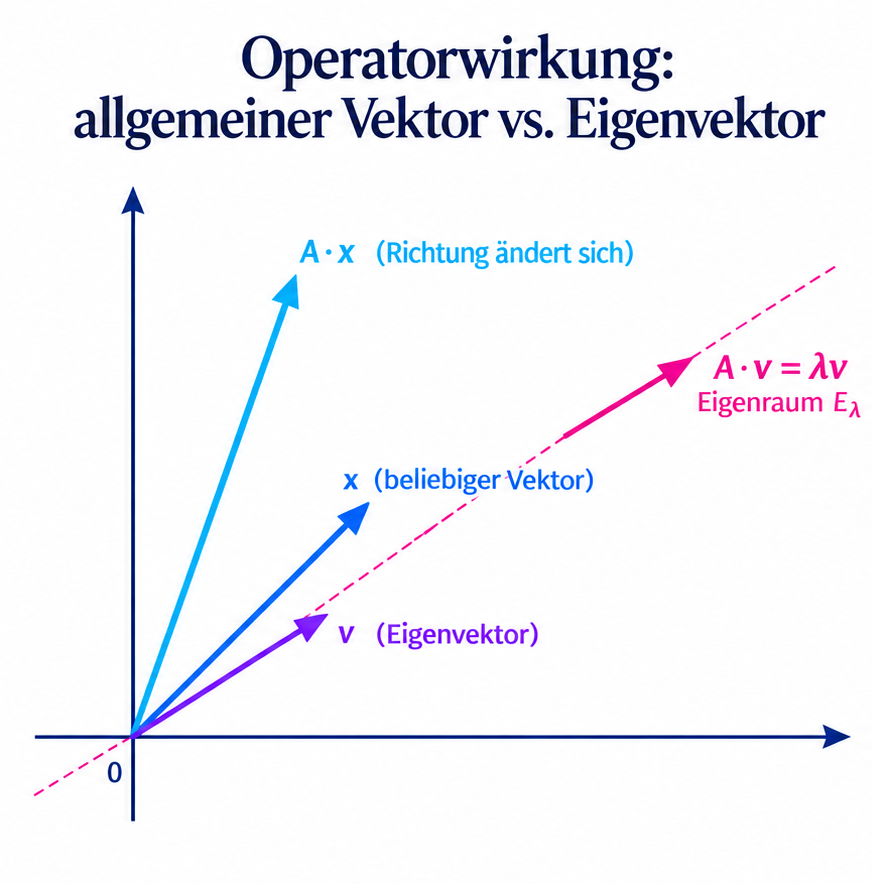
0.3 Eigenwert, Eigenvektor & Eigenraum
Experten-Ebene
Für einen linearen Operator A gilt Av=λv für einen Eigenvektor v≠0. Der zu λ gehörige Eigenraum ist Eλ = ker(A−λI). Allgemein skaliert |λ| die Norm des Eigenvektors. Ist A unitär, gilt |λ|=1; ist A hermitesch, sind alle Eigenwerte reell.
Für Dummies
Ein Eigenvektor ist eine Richtung, die der Operator nicht „wegkippt“. Er darf sie allgemein strecken oder stauchen. Bei unitären Operatoren bleibt die Länge erhalten: Der Eigenwert liefert nur eine Phase.
Memo-Mantra
Der Eigenvektor hält die Spur, λ bestimmt die Skalatur; bei Unitär bleibt |λ| eins – Phase nur.
0.4 Bra, Ket, inneres & äußeres Produkt
Experten-Ebene
Ein Ket |ψ⟩ ist ein Vektor; das zugehörige Bra ⟨ψ| ist sein adjungiertes Dualelement. Das innere Produkt ⟨φ|ψ⟩ ist ein Skalar. Das äußere Produkt |ψ⟩⟨φ| ist ein Operator; für normiertes |ψ⟩ ist P=|ψ⟩⟨ψ| ein Rang-1-Orthogonalprojektor.
Für Dummies
Bra mal Ket ergibt eine Zahl: Wie stark überlappen zwei Zustände? Ket mal Bra ergibt dagegen eine kleine „Maschine“, die Vektoren auf eine Richtung projizieren kann.
Memo-Mantra
Bra vor Ket gibt Zahl und Sicht; Ket vor Bra baut Operatorgewicht.
0.5 Adjungiert, hermitesch, unitär
Experten-Ebene
Die Adjungierte A† ist durch ⟨Ax|y⟩ = ⟨x|A†y⟩ definiert. In einer Orthonormalbasis ist A† die komplex-konjugierte Transponierte. Hermitesch bedeutet A=A†; unitär bedeutet U†U=I. Hermitesche Operatoren haben reelle Spektren, unitäre Operatoren erhalten Skalarprodukte und Normen.
Für Dummies
Das Dagger † ist die Regel für den Seitenwechsel im Skalarprodukt. Ein hermitescher Operator sieht nach diesem Seitenwechsel gleich aus. Ein unitärer Operator kann vollständig rückgängig gemacht werden, weil U⁻¹=U† gilt.
Memo-Mantra
Wechselt A die Seite, kommt † dazu; ist U unitär, führt U† zurück im Nu.
Modul 1 · Zustandsraum, Qubits & Unitäre Evolution
Ein reiner Qubit-Zustand ist physikalisch ein Strahl im zweidimensionalen komplexen Hilbertraum. Nach Normierung und Entfernen der globalen Phase lässt er sich auf der Bloch-Kugel darstellen. Geschlossene Quantendynamik und ideale Quantengatter werden durch unitäre Operatoren beschrieben.
Terminologie Hilbertraum (vollständiger komplexer Vektorraum mit Skalarprodukt), Unitär (längenerhaltend, invertierbar über ), Bra-Ket-Notation (Ket ist Spaltenvektor, Bra ist Zeilenvektor der komplex-konjugierten Werte).
1.1 Zustand & Normierung
Experten-Ebene
1. Zustand & Normierung: Der physikalische Zustandsraum ist der projektive Raum . Ein reiner Zustand ist ein Vektor mit Amplituden . Die Normierungsbedingung verlangt .
Für Dummies
Der Vektor auf der Kugel: Ein Qubit ist ein Zeiger der Länge 1. Er kann nicht nur auf 0 (Nordpol) oder 1 (Südpol) zeigen, sondern auf jeden Punkt der Oberfläche. Die Quadrate der Längen und sind die Chancen, bei einer Messung 0 oder 1 zu finden.
Memo-Mantra
Bleibt die Norm auf Eins geeicht, ist der Qubit-Zustand korrekt erreicht.
1.2 Unitäre Operatoren
Experten-Ebene
2. Unitäre Operatoren: Transformationen werden durch Operatoren beschrieben, für die gilt ( ist die komplex-konjugierte Transponierte). Aus der Adjungiertheit folgt die Normerhaltung: .
Für Dummies
Starre Drehung: Ein Quantengatter verzerrt oder staucht den Zustandspfeil nicht. Es ist eine normerhaltende unitäre Transformation; beim einzelnen Qubit entspricht die physikalisch relevante Wirkung – bis auf eine globale Phase – einer Rotation der Bloch-Kugel. Die Gesamtwahrscheinlichkeit bleibt vor und nach der Drehung exakt 100%.
Memo-Mantra
Dreht U den Zustand ohne Verlust, bleibt seine Norm erhalten – ganz bewusst.
1.3 Pauli-Algebra
Experten-Ebene
3. Pauli-Algebra: Die Pauli-Matrizen , , bilden zusammen mit der Einheitsmatrix eine orthogonale Basis des reellen Vektorraums der hermiteschen -Matrizen bezüglich des Hilbert-Schmidt-Skalarprodukts . Drehungen: .
Für Dummies
Die Pauli-Matrizen X, Y und Z sind die elementaren Achsenoperationen. Auf der Bloch-Kugel entsprechen sie – bis auf eine globale, physikalisch irrelevante Phase – 180°-Rotationen um x, y und z. Allgemeine Einzel-Qubit-Unitäre entsprechen einer Rotation plus globaler Phase.
Memo-Mantra
X, Y, Z geben Achsen und Sinn; bis auf globale Phase steckt Rotation darin.
1.4 Bloch-Kugel-Darstellung
Experten-Ebene
4. Bloch-Kugel-Darstellung: Durch Elimination der globalen Phase lässt sich jeder reine Zustand eineindeutig auf die Oberfläche der Einheitssphäre abbilden: mit Polarwinkel und Azimutwinkel .
Für Dummies
Geografische Landkarte: Jeder reine Zustand hat eine Breiten- () und eine Längenkoordinate (). Der Abstand vom Mittelpunkt ist immer exakt 1.
Memo-Mantra
θ und φ bestimmen den Ort; die globale Phase fällt physikalisch fort.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Mathematisch & Dimensionen):
Nehmen wir den Zustand .
Vektordimension: komplexer Spaltenvektor.
Einheit / Dimension: Dimensionslos. Die Komponenten und sind reine Wahrscheinlichkeitsamplituden.
Norm-Berechnung: .
Wirkung des Hadamard-Gatters :
. Eine unitäre Transformation dreht den Basiszustand genau auf den Äquator der Bloch-Kugel ().
Modul 2 · Physikalische Dynamik & Lie-Algebren
Die Schrödinger-Gleichung erzeugt die kontinuierliche Zeitentwicklung geschlossener Systeme. Der Hamilton-Operator H ist hermitesch; der eigentliche Lie-Algebra-Generator der unitären Entwicklung ist −iH/ħ. Für zeitunabhängiges H gilt U(t)=exp(−iHt/ħ).
Terminologie Hamilton-Operator (Energie-Operator), Hermitesch (, garantiert reelle Eigenwerte = messbare Energiewerte), Kommutator (), Matrixexponential ().
2.1 Zeitentwicklung & Generator
Experten-Ebene
Die Zeitentwicklung erfüllt iħ ∂ₜ|ψ(t)⟩ = H|ψ(t)⟩. Für zeitunabhängiges H=H† gilt U(t)=exp(−iHt/ħ). Der schiefhermitesche Operator X=−iH/ħ liegt in der Lie-Algebra 𝔲(d) der unitären Gruppe U(d) und ist der Generator dieser Zeitentwicklung; H selbst ist der hermitesche Energieoperator.
Für Dummies
Der Motor der Zeit: Der Hamilton-Operator enthält die Energie des Systems. Er steuert wie ein Motor, mit welcher Geschwindigkeit und um welche Achse sich der Zustand im Laufe der Zeit dreht.
Memo-Mantra
Hermitesch treibt H die Zeit voran, unitär kommt U als Entwicklung an.
2.2 Lie-Algebra
Experten-Ebene
Lie-Algebra 𝔲(d): Die Lie-Algebra der unitären Gruppe U(d) besteht aus schiefhermiteschen Matrizen X†=−X. Für einen Hamilton-Operator H=H† ist X=−iH/ħ ein solcher Generator. Die Lie-Klammer ist der Kommutator [A,B]=AB−BA. Die Unteralgebra 𝔰𝔲(d) besteht zusätzlich aus spurlosen schiefhermiteschen Matrizen. Für Observablen A und B bedeutet [A,B]≠0, dass sie im Allgemeinen keine gemeinsame Eigenbasis besitzen; eine gleichzeitige scharfe Bestimmung ist daher nicht allgemein möglich. Die quantitative Unschärferelation ist zustandsabhängig.
Für Dummies
Reihenfolge verändert das Ergebnis: Wenn zwei Operationen nicht kommutieren (), macht es einen physischen Unterschied, ob man erst und dann ausführt oder umgekehrt. Der Kommutator misst exakt diesen Unterschied.
Memo-Mantra
Vertauscht A mit B nicht im Revier, verrät der Kommutator die Reihenfolge hier.
2.3 Baker-Campbell-Hausdorff (BCH) & Trotterisierung
Experten-Ebene
3. Baker-Campbell-Hausdorff (BCH) & Trotterisierung: Für gilt . Für Quantensimulationen nutzt man die Lie-Trotter-Produktformel: .
Für Dummies
Zerlegen von komplexen Bewegungen: Möchte man ein System simulieren, dessen Energie aus zwei nicht-kommutierenden Teilen und besteht, führt man abwechselnd winzige Schritte von und aus.
Memo-Mantra
Viele kleine Schritte statt ein großer Sprung – Trotter hält die Näherung in Bewegung.
2.4 Globale Phase & physikalische Äquivalenz
Experten-Ebene
4. Eichinvarianz & Globale Phase: Zustände, die sich nur um eine globale Phase unterscheiden (), beschreiben denselben physikalischen Zustand. Physikalisch beobachtbar sind ausschließlich relative Phasen zwischen Superpositionskomponenten.
Für Dummies
Der unsichtbare globale Zeiger: Dreht man das gesamte System absolut synchron im Kreis, bemerkt kein Messgerät der Welt diese globale Phase. Nur Phasenunterschiede zwischen zwei Teilwegen erzeugen sichtbare Interferenzmuster.
Memo-Mantra
Dreht alles gleich, bleibt es unsichtbar; relative Phase macht Interferenz erst wahr.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Physikalische Einheiten & Dimensionen):
Ein Spin-1/2-Teilchen im konstanten Magnetfeld entlang der Z-Achse hat den Hamilton-Operator:
H = \frac{- \hslash\omega_{0}}{2}\sigma_{z} = \begin{pmatrix}
\frac{- \hslash\omega_{0}}{2} & 0 \\
0 & \frac{\hslash\omega_{0}}{2}
\end{pmatrix}.
Einheiten-Analyse:
(Wirkungsquantum).
(Larmor-Kreisfrequenz).
(Einheit der Energie).
.
Der Exponent der Zeitentwicklung hat die Einheit (dimensionslos, wie für Exponenten mathematisch zwingend gefordert!).
Explizite Zeitentwicklung für den Startzustand :
U(t) = \exp\left( \frac{- i}{\hslash}Ht \right) = \exp\left( i\frac{\omega_{0}t}{2}\sigma_{z} \right) = \begin{pmatrix}
e^{i\frac{\omega_{0}t}{2}} & 0 \\
0 & e^{- i\frac{\omega_{0}t}{2}}
\end{pmatrix}.
\left| \psi(t)\rangle = U(t) \right| + \rangle = \frac{1}{\sqrt{2}}\left( e^{i\frac{\omega_{0}t}{2}}\left| 0\rangle + e^{- i\frac{\omega_{0}t}{2}} \right|1\rangle \right) = e^{i\frac{\omega_{0}t}{2}}\frac{1}{\sqrt{2}}\left( \left| 0\rangle + e^{- i\omega_{0}t} \right|1\rangle \right).
Physikalisch entspricht dies einer Präzessionsbewegung des Bloch-Vektors auf dem Äquator mit der Frequenz .
Modul 3 · Tensorprodukt, Verschränkung & Fehlerkorrektur
Mehrteilchensysteme werden durch Tensorprodukte beschrieben. Dadurch wächst die Zustandsraumdimension multiplikativ und Verschränkung wird möglich: Zustände können existieren, die sich nicht als Produkt lokaler Zustände zerlegen lassen.
Terminologie Kronecker-Produkt (konkrete Matrix-Multiplikationsregel für Tensoren), Separabel (zerlegbar in Produktzustand), Bell-Basis (maximale Verschränkung von 2 Qubits), Schmidt-Rang (Anzahl der Nicht-Null-Koeffizienten ).
3.1 Tensorprodukt-Raum
Experten-Ebene
1. Tensorprodukt-Raum: Der Gesamtraum zweier Systeme (Dim ) und (Dim ) ist mit Dimension . Für Qubits gilt . Das Matrix-Produkt entspricht dem Kronecker-Produkt .
Für Dummies
Räumliche Explosion: Schaltest du Qubits zusammen, addieren sich die Dimensionen nicht, sondern sie multiplizieren sich. Bei 30 Qubits umfasst der Vektorraum bereits über eine Milliarde Einträge.
Memo-Mantra
Mit jedem Tensor wächst der Raum – addieren reicht hier kaum.
3.2 Separabilität vs. Verschränkung
Experten-Ebene
2. Separabilität vs. Verschränkung: Ein bipartiter Zustand heißt separabel, falls Vektoren und existieren mit . Lässt sich der Zustand nicht als einzelnes Produkt darstellen, heißt er verschränkt (z.B. Bell-Zustand ).
Für Dummies
Das Geisterband: Bei einem Produktzustand lassen sich den Teilsystemen eigene reine Zustände zuordnen. Bei einem verschränkten reinen Zustand ist das nicht möglich: Nur der Gesamtzustand ist als reiner Zustand vollständig beschrieben; die reduzierten Teilzustände können gemischt sein.
Memo-Mantra
Ist kein Produkt mehr möglich im Band, heißt Verschränkung der Gesamtzustand.
3.3 Schmidt-Zerlegung
Experten-Ebene
3. Schmidt-Zerlegung: Jeder reine bipartite Zustand besitzt eine Darstellung mit Orthonormalbasen und Schmidt-Koeffizienten , wobei . Der Schmidt-Rang ist Zustand ist separabel.
Für Dummies
Die Diagonalsicht: Egal wie hochgradig verwoben zwei Teilsysteme sind: Man kann für beide Seiten stets passende Koordinatensysteme wählen, sodass die Verschränkung aus exakten Paaren besteht.
Memo-Mantra
Schmidt sortiert die Paarung rein; Rang eins heißt: separabel sein.
3.4 Stabilizer-Formalismus
Experten-Ebene
4. Stabilizer-Formalismus: Fehlerkorrigierende Codes definieren den geschützten Code-Unterraum als gemeinsamen Eigenraum einer abelschen Untergruppe der -Qubit Pauli-Gruppe mit Eigenwert : .
Für Dummies
Schutz durch Redundanz: Statt ein Qubit direkt der Umwelt auszusetzen, verteilt man seine Information fehlergeschützt über den gemeinsamen, ungestörten Unterraum vieler verschränkter Qubits.
Memo-Mantra
Stabilizer prüfen den geschützten Raum; Redundanz hält logische Information im Zaum.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Mathematische Zerlegung & Beweis der Nicht-Separabilität):
Betrachten wir den Bell-Zustand .
Vektordimension: Spaltenvektor ().
Beweis der Nicht-Separabilität (Widerspruchsbeweis):
Nehmen wir an, wäre separabel als .
Koeffizientenvergleich mit :
oder .
oder .
.
Wäre , folgte aus (1) (Widerspruch). Wäre , folgte aus (4) (Widerspruch).
Somit existieren keine solchen Amplituden . Der Zustand ist strikt verschränkt.
Modul 4 · Messprozess, Dualraum & Operatorenalgebra
Messungen verbinden Zustandsraum, Dualraum und Spektraltheorie. Hermitesche Observablen besitzen reelle Eigenwerte; die Born-Regel liefert Ergebniswahrscheinlichkeiten. Der adjungierte Operator ist das zentrale Werkzeug zum Umformen von Erwartungswerten.
Terminologie Bra/Ket-Dualität (Ket = Spalte, Bra = konjugierte Zeile), Projektor (), PVM (Projection-Valued Measure), Erwartungswert .
4.1 Dualraum & Riesz-Isomorphismus
Experten-Ebene
1. Dualraum & Riesz-Isomorphismus: Der Dualraum besteht aus allen stetigen linearen Funktionalen . Der Riesz’sche Darstellungssatz garantiert die Existenz einer antilinearen Isometrie , die jedem Ket das Bra zuordnet. Dualbasis-Eigenschaft: . Koeffizientenauslese: .
Für Dummies
Pfeil und Messlineal: Das Ket ist das Quantenobjekt (der Pfeil). Das Bra ist das passende Messlineal. Das Produkt misst den Schattenwurf des Pfeils auf das Lineal. Die Dualbasis liest die Komponenten direkt aus.
Memo-Mantra
Ket ist Zustand, Bra stellt die Frage – Riesz verbindet beide Lage.
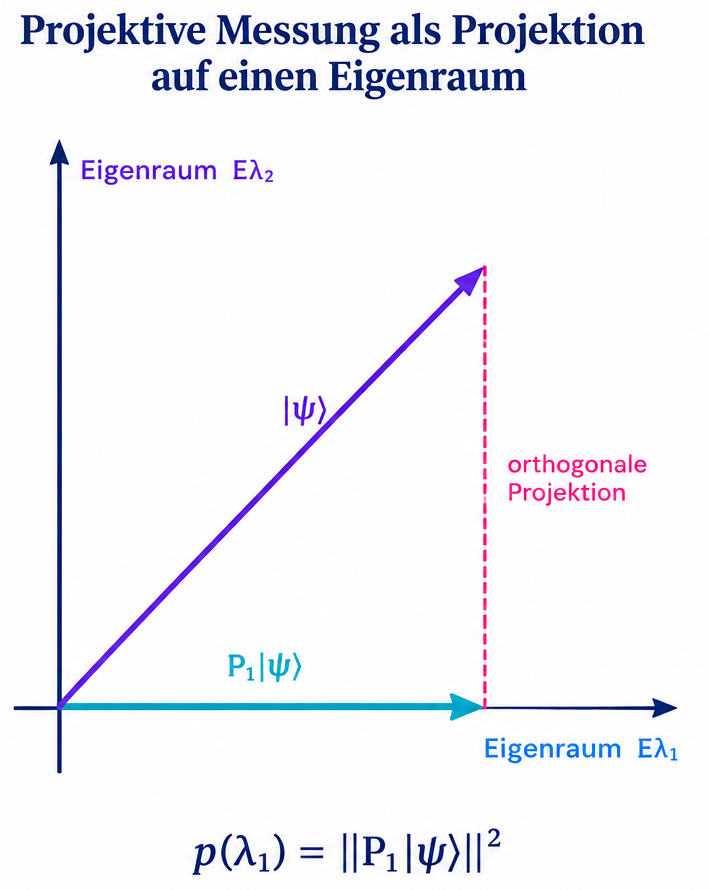
4.2 Projektive Messungen (PVM) & Bornsche Regel
Experten-Ebene
2. Projektive Messungen (PVM) & Bornsche Regel: Eine Observable ist ein hermitescher Operator mit reellen Eigenwerten und Projektoren . Die Wahrscheinlichkeit, bei der Messung von den Wert zu erhalten, lautet . Der Zustand kollabiert instantan zu .
Für Dummies
Das Messgerät stellt eine Frage mit möglichen Eigenwert-Antworten. Die Born-Regel sagt, wie wahrscheinlich jede Antwort ist. Nach einem idealen projektiven Messergebnis aktualisiert man den Zustand auf den zugehörigen Eigenraum – das ist die formale Messzustands-Änderung.
Memo-Mantra
Born macht aus Amplitude Wahrscheinlichkeit; der Projektor wählt den Ergebnisraum bereit.
4.3 Sesquilinearform & Adjungiertheit
Experten-Ebene
3. Sesquilinearform & Adjungiertheit: Das Skalarprodukt ist antilinear im ersten und linear im zweiten Argument: . Der adjungierte Operator wird definiert über . Für Hermitesche Operatoren gilt (reelle Spektren). Für Unitäre Operatoren gilt (Isometrien).
Für Dummies
Die Tennis-Regel: Wandert ein Operator im Skalarprodukt über das Netz nach rechts, verwandelt er sich in seine Adjungierte . Komplexe Faktoren auf der linken Seite werden komplex-konjugiert ().
Memo-Mantra
Wechselt A im Skalarprodukt die Seit, kommt A† als Begleit.
4.4 Schrödinger- vs. Heisenberg-Bild
Experten-Ebene
4. Schrödinger- vs. Heisenberg-Bild: Die Äquivalenz der Zeitentwicklung im Erwartungswert wird über die Operator-Adjungierte gezeigt: . Im Heisenberg-Bild ist der Zustand zeitlich starr , während die Observable gemäß dynamisch evolviert.
Für Dummies
Kamera oder Objekt drehen? Du kannst entweder den Quantenzustand mit der Zeit drehen (, Schrödinger-Bild) oder den Zustand starr lassen und das Messgerät entgegengesetzt drehen (, Heisenberg-Bild). Das Ergebnis ist identisch.
Memo-Mantra
Dreh Zustand oder Messgerät im Raum – der Erwartungswert bleibt derselbe Traum.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Konkrete Vektor- und Matrix-Rechnung):
Zustand .
Bildung des Bra-Vektors (Riesz-Isomorphismus):
\langle\psi \vee \left( \psi\rangle \right)^{\dagger} = \begin{pmatrix}
\left( \frac{3}{5} \right)^{} & \left( \frac{4}{5}i \right)^{}
\end{pmatrix} = \begin{pmatrix}
\frac{3}{5} & \frac{- 4}{5}i
\end{pmatrix} \in \left( C^{2} \right)^{}.
Skalarprodukt (Bra-Ket Skalar):
. (Dimensionslose Norm 1).
Äußeres Produkt (Ket-Bra Matrix-Projektor):
P_{\psi} = \left| \psi\rangle\langle\psi \right| = \begin{pmatrix}
\frac{3}{5} \\
\frac{4}{5}i
\end{pmatrix}\begin{pmatrix}
\frac{3}{5} & \frac{- 4}{5}i
\end{pmatrix} = \begin{pmatrix}
\frac{9}{25} & \frac{- 12}{25}i \\
\frac{12}{25}i & \frac{16}{25}
\end{pmatrix}.
Messung der Pauli-Z-Observable :
Erwartungswert .
Einheit: Dimensionslos (da Eigenwerte und ohne physikalische Einheit hat).
Modul 5 · Dichtematrizen, Spurklasse & Gemischte Zustände
Dichtematrizen verallgemeinern reine Zustände und beschreiben sowohl klassische Unsicherheit als auch reduzierte Zustände offener oder verschränkter Systeme. Positivität, Hermitizität und Spur 1 sichern die Wahrscheinlichkeitsinterpretation.
Terminologie Dichteoperator , Gemischter Zustand (), Partielle Spur , Von-Neumann-Entropie .
5.1 Axiomatik der Dichtematrix
Experten-Ebene
1. Axiomatik der Dichtematrix: Ein Dichteoperator erfüllt drei fundamentale Postulate: (1) (Hermitizität); (2) (Positivität); (3) (Spurnormierung). Ensembledarstellung: mit und .
Für Dummies
Der Wahrscheinlichkeits-Cocktail: Ein reiner Zustand ist ein exakter Pfeil. Ein gemischter Zustand ist ein Mischgetränk: Du kennst nur die Rezeptur (z.B. Chance für Zustand 1, für Zustand 2). Die Dichtematrix bündelt dieses Wissen in einem mathematischen Objekt.
Memo-Mantra
Positiv, hermitesch, Spur gleich eins – dann kann ρ ein Zustand sein.
5.2 Purity (Reinheit) & Spektraleigenschaften
Experten-Ebene
2. Purity (Reinheit) & Spektraleigenschaften: Da , existiert eine Spektralzerlegung mit Eigenwerten . Die Reinheit ist definiert als . Reiner Zustand:. Maximal gemischter Zustand:.
Für Dummies
Ein gemischter Zustand kann zwei Ursachen widerspiegeln: klassische Unsicherheit darüber, welcher reine Zustand präpariert wurde, oder echte lokale Gemischtheit, weil unser System mit einer Umwelt bzw. einem anderen Teilsystem verschränkt ist.
Memo-Mantra
Ist Tr(ρ²) eins, ist ρ rein; kleiner heißt: gemischter sein.
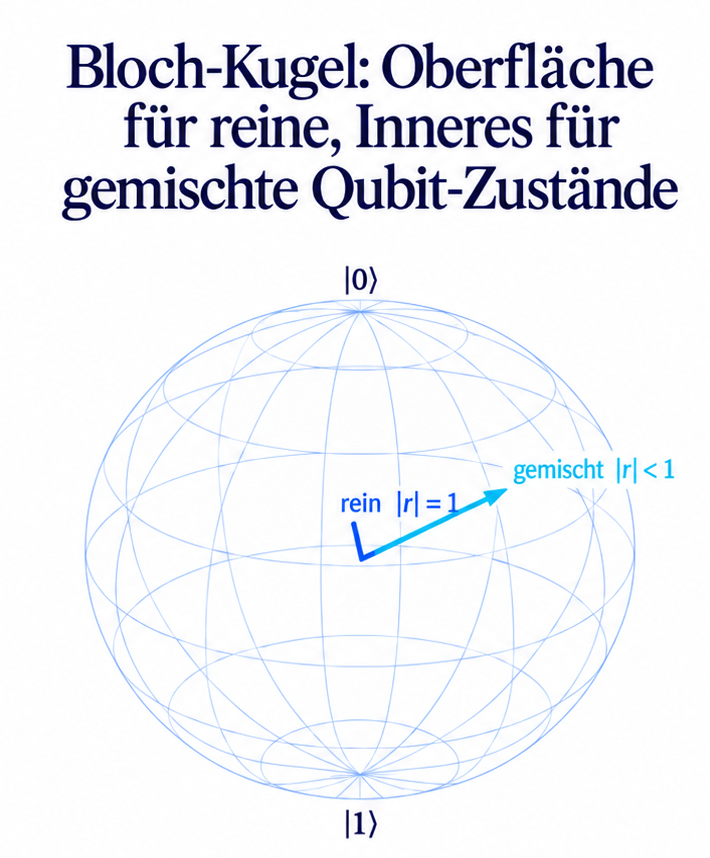
5.3 Geometrie der Bloch-Kugel ()
Experten-Ebene
3. Geometrie der Bloch-Kugel (): Für ein Qubit bildet die Menge aller Dichtematrizen eine konvexe Menge im : . Der Bloch-Vektor erfüllt . Rand (): reine Zustände; Inneres (): gemischte Zustände; Mittelpunkt (): maximal gemischter Zustand .
Für Dummies
Kugeloberfläche vs. Kugelinneres: Reine Zustände liegen auf der Oberfläche der Bloch-Kugel. Mischung oder etwa depolarisierendes Rauschen kann den Bloch-Vektor ins Innere verschieben. Im Mittelpunkt r=0 liegt der maximal gemischte Zustand I/2. Nicht jeder Quantenkanal „schrumpft“ den Vektor einfach radial – allgemeine Kanäle können ihn auch drehen oder verschieben.
Memo-Mantra
Am Rand ist rein, im Innern gemischt; der Bloch-Vektor zeigt, wie viel Reinheit erwischt.
5.4 Partielle Spur (Partial Trace)
Experten-Ebene
4. Partielle Spur (Partial Trace): Für ein bipartites System wird der reduzierte Dichteoperator von Teilsystem durch Ausspuren von definiert: , wobei eine Orthonormalbasis von ist.
Für Dummies
Das mathematische Ausblenden: Interessiert dich bei zwei verschränkten Qubits und nur Qubit , spurst du aus. Du summierst die Effekte von mathematisch heraus und erhältst den lokalen Zustand .
Memo-Mantra
Spurst du B aus dem Ganzen hinaus, bleibt für A sein reduzierter Zustand heraus.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Ausspuren eines Bell-Zustands):
Gegeben sei der reine Bell-Zustand mit .
Dichtematrix-Darstellung in der Basis :
\rho_{AB} = \frac{1}{2}\begin{pmatrix}
1 & 0 & 0 & 1 \\
0 & 0 & 0 & 0 \\
0 & 0 & 0 & 0 \\
1 & 0 & 0 & 1
\end{pmatrix}.
Berechnung der partiellen Spur :
\frac{1}{2}\left| 0\rangle\left\langle 0\left| \frac{+ 1}{2} \right|1 \right\rangle\langle 1 \right| = \frac{1}{2}\begin{pmatrix}
1 & 0 \\
0 & 1
\end{pmatrix} = \frac{1}{2}I_{2}.
Analyse des Ergebnisses :
Dimension: Matrix.
Spur: (100% Wahrscheinlichkeitsnormierung).
Reinheit: .
Erkenntnis: Obwohl der Gesamtzustand rein war (), ist der reduzierte Zustand maximal gemischt (). Das ist das fundamentale Kennzeichen maximaler quantenmechanischer Verschränkung!
Modul 6 · Quantenkanäle & der invertierte Messkanal
Allgemeine physikalische Zustandsänderungen offener Systeme werden durch CPTP-Abbildungen beschrieben. Classical Shadows nutzen einen bekannten randomisierten Messkanal und – sofern dieser auf dem relevanten Operatorraum invertierbar ist – dessen Inverse, um unverzerrte Schätzer zu konstruieren.
Terminologie CPTP-Map (Completely Positive Trace-Preserving Map), Kraus-Operator, Superoperator (lineare Abbildung auf Operatoren), Classical Shadow ρ̂ (klassischer Schatten-Schätzer), Rekonstruktionsabbildung 𝓜⁻¹ (nicht notwendigerweise selbst ein physikalischer Quantenkanal).
6.1 CPTP-Axiomatik & Kraus-Darstellung
Experten-Ebene
1. CPTP-Axiomatik & Kraus-Darstellung: Ein Quantenkanal ist eine lineare Abbildung . Er ist (1) spurerhaltend () und (2) vollständig positiv (). Nach dem Kraus-Darstellungssatz existieren Operatoren mit , sodass .
Für Dummies
Das mathematische Rohr mit Rauschen: Ein Quantenkanal ist wie ein Datenkabel. Er darf Information verdrehen, dämpfen oder streuen, darf aber niemals Gesamtwahrscheinlichkeiten vernichten oder unphysikalische (negative) Wahrscheinlichkeiten erzeugen.
Memo-Mantra
CPTP hält Wahrscheinlichkeit intakt und Positivität kompakt.
6.2 Stinespring-Dilationssatz
Experten-Ebene
2. Stinespring-Dilationssatz: Jeder CPTP-Kanal lässt sich als eine reine unitäre Transformation auf einem größeren Gesamtraum (System + Umwelt) mit anschließender partieller Spur darstellen: .
Für Dummies
Die Umwelt als mathematischer Zeuge: Der Stinespring-Satz sagt nicht, dass jedes reale Rauschen mikroskopisch gleich aussehen muss. Er sagt, dass sich jeder CPTP-Kanal so darstellen lässt, als würde das System mit einer geeigneten Umwelt unitär evolvieren und man die Umwelt anschließend ausspuren.
Memo-Mantra
System plus Umwelt kann unitär sein; nach dem Ausspuren bleibt der Kanal allein.
6.3 Der Schatten-Messkanal
Experten-Ebene
Für ein festgelegtes Randomisierungs- und Messensemble definiert man einen linearen Messkanal 𝓜. Bei geeigneten Ensembles – etwa globalen Clifford-Messungen – besitzt 𝓜 eine einfache depolarisierende Form; bei lokalen Pauli/Clifford-Messungen faktorisiert der Kanal lokal. Die genaue Form hängt also vom Ensemble ab.
Für Dummies
Das stochastische Milchglas: Du drehst den Zustand zufällig (), liest ein Ergebnis ab () und drehst die Projektion zurück. Über alle Zufallsdrehungen gemittelt wirkt dieser Messprozess wie ein Milchglas: Er schwächt die ursprüngliche Information ab.
Memo-Mantra
Randomisieren, messen, zurücktransformieren – so lässt sich Information statistisch codieren.
6.4 Superoperator-Inversion
Experten-Ebene
Ein Classical Shadow wird als ρ̂ = 𝓜⁻¹(U†|b⟩⟨b|U) definiert, sofern 𝓜 auf dem relevanten Operatorraum invertierbar ist. Der Schätzer muss selbst keine positive Dichtematrix sein; entscheidend ist E[ρ̂]=ρ.
Für Dummies
Die scharfe Korrekturbrille: Weil wir die Mathematik der Zufallsdrehungen exakt kennen, wissen wir genau, wie stark das Milchglas dämpft. Der inverse Operator schärft das verwaschene Messergebnis nach, sodass im Mittel exakt der Originalzustand rekonstruiert wird.
Memo-Mantra
Ist M invertierbar im relevanten Raum, macht M⁻¹ aus Messdaten einen Schatten-Traum.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Explizite Schatten-Kanal-Inversion für 1 Qubit):
Wählt man als Ensemble die Einzel-Qubit Clifford-Gruppe, wirkt der Schatten-Messkanal auf eine beliebige Dichtematrix als depolarisierender Kanal:
M(\rho) = \frac{1}{3}\rho + \frac{2}{3}\frac{I_{2}}{2} = \frac{1}{3}\rho + \frac{1}{3}I_{2}.
Herleitung der Inversen :
Wir suchen eine Abbildung , sodass .
Setze den Ansatz :
\frac{a}{3}\rho + \frac{a}{3}I_{2} + b\left( \frac{1}{3} \cdot 1 + \frac{2}{3} \right)I_{2} = \frac{a}{3}\rho + \left( \frac{a}{3} + b \right)I_{2}.
Soll dies exakt gleich sein, folgt durch Koeffizientenvergleich:
.
.
Der inverse Superoperator lautet also: .
Berechnung eines konkreten Klassischen Schattens :
Angenommen, im Experiment wählen wir und messen den Zustand .
Der unkorrigierte Messprojektor ist .
Wir wenden die „Korrekturbrille“ darauf an:
\acute{\rho} = M^{- 1}(\left| 0\rangle\left\langle 0\left| ) = 3 \right|0 \right\rangle\langle 0 \right| - Tr\left( \left| 0\rangle\langle 0 \right| \right)I_{2} = 3\begin{pmatrix}
1 & 0 \\
0 & 0
\end{pmatrix} - 1 \cdot \begin{pmatrix}
1 & 0 \\
0 & 1
\end{pmatrix} = \begin{pmatrix}
2 & 0 \\
0 & - 1
\end{pmatrix}.
Überprüfung der Eigenschaften des Schätzers :
Spur: (Perfekt normierte Spur 1!).
Eigenwerte: .
Wichtige Erkenntnis: Ein einzelner Classical-Shadow-Schätzer kann negative Eigenwerte haben und muss daher keine physikalische Dichtematrix sein. Erwartungstreue bedeutet E[ρ̂]=ρ – nicht Positivität jedes Einzelschätzers.
Modul 7 · Classical Shadows & Stichprobenkomplexität
Classical Shadows komprimieren randomisierte Messdaten so, dass viele nachträglich gewählte Observablen geschätzt werden können. Die zentrale Komplexitätsgröße ist die Schatten-Norm; robustes Aggregieren wie Median-of-Means kontrolliert statistische Ausreißer.
Terminologie Schatten-Norm , Median-of-Means, Stichprobenkomplexität (Sample Complexity), Pauli- vs. Clifford-Ensemble, Nicht-lineare Eigenschafts-Rekonstruktion.
7.1 Stichprobenkomplexität & Varianzschranke
Experten-Ebene
Für M Zielobservablen O₁,…,O_M kann eine typische Classical-Shadows-Garantie in der Form N = O(maxᵢ ||Oᵢ||²_shadow · log(M/δ) / ε²) geschrieben werden. Damit werden alle M Erwartungswerte mit additivem Fehler ε und Fehlerwahrscheinlichkeit höchstens δ geschätzt.
Für Dummies
Abkürzungs-Trick mit Bedingungen: Derselbe Datensatz kann viele Zielobservablen gleichzeitig bedienen. Bleiben ihre Schatten-Normen klein, wächst der Messaufwand nur logarithmisch mit der Zahl M der gleichzeitig geforderten Vorhersagen – zusätzlich aber mit Genauigkeit und Konfidenz.
Memo-Mantra
Viele Fragen, wenig Messzeit – die Schatten-Norm bestimmt den Aufwand bereit.
7.2 Median-of-Means Estimator
Experten-Ebene
Median-of-Means teilt unabhängige Schatten in mehrere Blöcke, mittelt innerhalb jedes Blocks und nimmt anschließend den Median der Blockschätzer. Die Konstruktion verstärkt eine Varianzschranke zu hoher Erfolgswahrscheinlichkeit, ohne dünne Verteilungsschwänze vorauszusetzen.
Für Dummies
Man bildet mehrere kleine Durchschnittswerte und nimmt anschließend den Median. Einzelne extreme Messwerte können dadurch das Endergebnis deutlich weniger stark verzerren – robust, aber nicht „magisch unfehlbar“.
Memo-Mantra
Blockweise mitteln, den Median wählen – so können Ausreißer weniger quälen.
7.3 Lokale vs. Globale Ensembles
Experten-Ebene
Das Messensemble bestimmt die Schatten-Norm. Für lokale Pauli-Messungen wächst der Aufwand für Pauli-Observablen vom Gewicht k typischerweise wie 3^k, unabhängig von der Gesamtzahl n der Qubits. Globale Clifford-Messungen können dagegen für bestimmte globale, insbesondere niedrig-rangige Observablen günstiger sein.
Für Dummies
Richtige Brille für das richtige Problem: Drehst du jedes Qubit einzeln zufällig (lokal), erkennst du lokale Details perfekter. Drehst du alle Qubits gemeinsam verschränkt (global), misst du Gesamteigenschaften des ganzen Systems mit einem einzigen Blick.
Memo-Mantra
Lokal für Lokales, global für global – das Ensemble entscheidet über die Varianz-Zahl.
7.4 Vorhersage nicht-linearer Eigenschaften
Experten-Ebene
Vorhersage nichtlinearer Eigenschaften: Sind ρ̂₁ und ρ̂₂ unabhängige, erwartungstreue Classical-Shadow-Schätzer desselben Zustands ρ, dann gilt E[Tr(ρ̂₁ρ̂₂)] = Tr(ρ²). Damit lässt sich zum Beispiel die Purity ohne vollständige Zustandstomographie schätzen. Für andere polynomiale Funktionale kann man analoge unabhängige Schattenprodukte konstruieren; allgemeine nichtlineare Größen benötigen jeweils eigene Schätzer und Fehleranalysen.
Für Dummies
Schatten-Kombination für komplexere Größen: Zwei unabhängige Schatten erlauben beispielsweise einen unverzerrten Schätzer der Reinheit Tr(ρ²). Für andere nichtlineare Größen – insbesondere allgemeine Verschränkungsmaße – braucht man jeweils passende, eigens hergeleitete Schätzer.
Memo-Mantra
Zwei unabhängige Schatten im Paar können auch nichtlineare Größen schätzen – wunderbar.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Explizite Erwartungswert-Berechnung einer Pauli-Z-Observable):
Gegeben sei der gemessene Einzel-Schatten (aus Modul 6).
Wir wollen den Erwartungswert der Observable berechnen.
Mathematische Auswertung des Schätzers :
Dimensions- & Einheiten-Analyse:
Matrix-Dimensionen: .
Einheiten: Dimensionslos (Sowohl Projektor als auch Pauli-Observablen tragen keine physikalischen Einheiten).
Interpretation: Ein Einzelwert liegt außerhalb des Spektrums von (). Erst über das mathematische Mittel vieler Zufallsmessungen konvergiert dieser Wert exakt gegen den echten Erwartungswert .
Modul 8 · Quanteninformation, Entropie & Holevo-Schranke
Quanteninformation wird mit Entropien und Korrelationsmaßen quantifiziert. Die Von-Neumann-Entropie misst die spektrale Unbestimmtheit eines Zustands; die Holevo-Schranke begrenzt die ohne zusätzliche Ressourcen zugängliche klassische Information eines Quantenzustandsensembles.
Terminologie Von-Neumann-Entropie , Relativ-Entropie , Quantum Mutual Information , Holevo-Größe , Data Processing Inequality.
8.1 Von-Neumann-Entropie
Experten-Ebene
Von-Neumann-Entropie: Für eine Dichtematrix mit Spektralzerlegung lautet die Entropie . Für reine Zustände gilt , für den maximal gemischten Zustand eines -dimensionalen Raums gilt .
Für Dummies
Das Maß der Gemischtheit: Die Von-Neumann-Entropie quantifiziert die spektrale Unbestimmtheit eines Zustands. Ein reiner Zustand hat Entropie Null; der maximal gemischte Zustand hat maximale Entropie. Bei reduzierten Zuständen kann hohe Entropie auch aus Verschränkung mit einem anderen Teilsystem entstehen – nicht nur aus klassischer Unkenntnis.
Memo-Mantra
Ist ρ rein, bleibt S bei null; maximale Mischung macht S maximal voll.
8.2 Relativ-Entropie & Starke Subadditivität
Experten-Ebene
Die Quanten-Relativentropie D(ρ||σ)=Tr[ρ(logρ−logσ)] ist für supp(ρ)⊆supp(σ) definiert; andernfalls setzt man D(ρ||σ)=∞. Sie ist nichtnegativ, aber weder symmetrisch noch ein metrischer Abstand. Ihre Monotonie unter CPTP-Abbildungen ist die Data Processing Inequality. Starke Subadditivität lautet S(AB)+S(BC) ≥ S(B)+S(ABC).
Für Dummies
Die Relativentropie ist eher ein gerichteter Informationsverlust als ein geometrischer Abstand: ρ gegen σ zu testen ist nicht dasselbe wie σ gegen ρ. Trotzdem sagt die Größe sehr viel darüber aus, wie gut zwei Zustände informations-theoretisch auseinanderzuhalten sind.
Memo-Mantra
Relative Entropie ist kein Abstand im Raum, doch als Divergenz trägt sie Informations-Traum.
8.3 Quantum Mutual Information
Experten-Ebene
Die Quantum Mutual Information I(A:B)=S(A)+S(B)−S(AB) misst die gesamten Korrelationen zwischen A und B. Für einen reinen maximal verschränkten Zustand zweier d-dimensionaler Systeme gilt I(A:B)=2 log₂ d.
Für Dummies
Der Gesamtwert der Verbindung: misst, wie viel Information Teilsystem über Teilsystem enthält. Für zwei d-dimensionale Systeme kann die Quanten-Mutual-Information bis 2 log₂ d erreichen; zum Vergleich ist die klassische Mutual Information zweier d-wertiger Variablen höchstens log₂ d.
Memo-Mantra
Was A über B an Korrelation kennt, wird durch I(A:B) kompakt benannt.
8.4 Holevo-Schranke (Holevo Bound)
Experten-Ebene
Holevo-Schranke (Holevo Bound): Werden klassische Nachrichten mit Wahrscheinlichkeit als Quantenzustände präpariert (), ist die extrahierbare klassische Information durch die Holevo-Größe beschränkt: .
Für Dummies
Ein einzelnes Qubit kann ohne zusätzliche gemeinsame Ressource höchstens ein Bit zugängliche klassische Information tragen. Mit vorher geteilter Verschränkung gelten andere Kommunikationsszenarien – Superdense Coding ist das berühmte Beispiel.
Memo-Mantra
Holevo setzt dem Auslesen Schranken ein; ohne Zusatzressource passt in ein Qubit höchstens ein klassisches Bit hinein.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Berechnung der Von-Neumann-Entropie eines thermischen Zustands):
Gegeben sei ein gemischter Qubit-Zustand .
Schritt 1: Bestimmung der Eigenwerte:
Da bereits diagonal ist, lesen wir die Eigenwerte direkt ab: und .
Schritt 2: Anwenden der Entropie-Formel:
Berechnung der Logarithmen zur Basis 2:
Einsetzen der Werte:
Dimensions- & Einheiten-Analyse:
Matrix-Dimension: .
Einheit: Bits (oder Shannons), dimensionslos da Argumente Wahrscheinlichkeiten sind.
physikalische Interpretation: Ein Wert von Bits zeigt, dass der Zustand zwischen rein ( Bit) und maximal gemischt ( Bit) liegt.
Modul 9 · Quantenalgorithmen, QFT & Phasenschätzung
QFT, Quantum Phase Estimation und Amplitudenverstärkung sind zentrale Bausteine ausgewählter Quantenalgorithmen. Der Geschwindigkeitsvorteil entsteht nicht allein aus der QFT, sondern aus der gesamten Problemstruktur und einer effizienten Implementierung der benötigten unitären Operationen.
Terminologie Quanten-Fourier-Transformation (QFT), Quantum Phase Estimation (QPE), Phasengatter , Amplitude Amplification, Einheitswurzel .
9.1 QFT als Basiswechsel
Experten-Ebene
QFT als Basiswechsel: Die QFT ist eine unitäre Transformation , die Basiszustände in Superpositionen der Phase überführt: mit dem Einheitswurzel-Faktor ().
Für Dummies
Das Quanten-Prisma: Die QFT ist ein Basiswechsel. Sie übersetzt die Amplitudenstruktur in der Rechenbasis in eine Fourier-Basis, in der periodische Phasen- und Frequenzstrukturen sichtbar werden können.
Memo-Mantra
Die QFT wechselt die Basis im Nu und macht Phasenstruktur zugänglich dazu.
9.2 Quantum Phase Estimation (QPE)
Experten-Ebene
Quantum Phase Estimation (QPE): Gegeben sei ein unitärer Operator mit Eigenvektor und Eigenwert . QPE rekonstruiert die Phase binär in ein Hilfsregister über kontrollierte -Gatter und eine anschließende inverse QFT ().
Für Dummies
QPE ist eine Quanten-Uhr für Eigenphasen. Ist die Phase mit den verfügbaren Bits exakt darstellbar, kann sie ideal exakt erscheinen; sonst erhält man eine probabilistische Näherung, die mit mehr Hilfsqubits feiner wird.
Memo-Mantra
Ist U|ψ⟩=e^{2πiθ}|ψ⟩ gegeben, hilft QPE, θ binär zu heben.
9.3 Periodenfindung (Shor-Algorithmus)
Experten-Ebene
Im Shor-Algorithmus wird Faktorisierung auf das Finden einer multiplikativen Ordnung reduziert. Die Quantenroutine löst das Order-Finding effizient mithilfe von Phasenschätzung; mit Standardarithmetik ergibt sich eine polynomial skalierende Gesamtlaufzeit in der Bitlänge des zu faktorisierenden Integers.
Für Dummies
Versteckte Muster finden: Der Shor-Algorithmus probiert nicht alle Zahlen aus. Er nutzt die QFT, um die verdeckte Taktfrequenz (Periode) mathematischer Gleichungen schlagartig sichtbar zu machen.
Memo-Mantra
Findest du die Ordnung im modularen Lauf, baut Shor daraus die Faktorisierung auf.
9.4 Amplitude Amplification (Grover)
Experten-Ebene
Amplitude Amplification (Grover): Operatoren der Form (Reflexion am Startzustand und am Zielraum) rotieren den Zustandsvektor in dem zweidimensionalen Unterraum, der von den markierten und unmarkierten Anteilen aufgespannt wird. Dies führt zu einem quadratischen Speedup .
Für Dummies
Gezieltes Aufschaukeln: Grover löscht falsche Antworten durch destruktive Interferenz aus und verstärkt die Amplitude der richtigen Antwort konstruktiv, bis diese fast zu 100% gemessen wird.
Memo-Mantra
Grover dreht im Zweiraum Stück für Stück, bis die Zielamplitude wächst mit √N-Geschick.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (1-Qubit QFT – Die Äquivalenz zum Hadamard-Gatter):
Betrachten wir die QFT für ein einzelnes Qubit ().
Der Parameter lautet: .
Transformation der Basiszustände :
Für :
Für :
Matrix-Darstellung der 1-Qubit QFT:
Dimensions- & Einheiten-Analyse:
Matrix-Dimension: .
Vektordimension: .
Einheiten: Dimensionslos. Der Faktor sichert die Unitarität ().
Modul 10 · Topologische Quantenfehlerkorrektur & Stabilizer-Codes
Quantenfehlerkorrektur schützt logische Information, indem sie sie redundant in Unterräume vieler physischer Qubits kodiert. Stabilizer-Syndrome verraten Fehlerklassen, ohne die logische Information selbst auszulesen; topologische Codes nutzen zusätzlich räumliche Struktur.
Terminologie Stabilizer-Gruppe , Code-Unterraum , Fehlersyndrom, Surface Code, Transversale Gatter, Eastin-Knill-Theorem, Magic State Distillation.
10.1 Stabilizer-Formalismus
Experten-Ebene
Stabilizer-Formalismus: Ein -Stabilizer-Code codiert logische Qubits in physische Qubits mit Distanz . Der Code-Unterraum ist der gemeinsame -Eigenraum einer abelschen Untergruppe der Pauli-Gruppe (mit ): .
Für Dummies
Unstörbarer Versteck-Raum: Statt ein Qubit direkt der Umwelt auszusetzen, baut man ein Netz aus vielen physischen Qubits. Man definiert Regeln (Stabilizern), die festlegen, dass das System nur in einem ganz bestimmten, geschützten Unterraum existieren darf.
Memo-Mantra
Stabilizer halten den Coderaum fest; +1 für jede Regel ist der Test.
10.2 Syndrom-Messung & logische Information
Experten-Ebene
Eine Stabilizer-Syndrommessung projiziert den physikalischen Zustand auf einen Syndrom-Unterraum, liest aber – bei korrekt konstruiertem Code und korrigierbaren Fehlern – die kodierte logische Information nicht aus. Kommutations- bzw. Antikommutationsmuster der Fehler mit den Generatoren bestimmen das Syndrom.
Für Dummies
Die Alarmanlage misst nicht die geheime Nachricht, sondern nur, welche Schutzregel verletzt wurde. Formal findet dabei sehr wohl eine Projektion statt – aber auf eine Weise, die die logische Information bei korrigierbaren Fehlern erhält.
Memo-Mantra
Das Syndrom liest den Fehler, nicht das logische Wort – so bleibt die Information am geschützten Ort.
10.3 Surface Code & Topologie
Experten-Ebene
Im kanonischen Surface-/Toric-Code liegen Datenqubits je nach Konvention auf Kanten oder in der verbreiteten rotierten Darstellung auf Gitterplätzen; X- und Z-Stabilizer sind lokal. Logische Operatoren entsprechen nichttrivialen Ketten, die die Topologie bzw. die Codegrenzen verbinden.
Für Dummies
Schutz durch Geometrie: Lokale Fehler erzeugen lokale Syndromsignale. Ein logischer Fehler entsteht, wenn der tatsächliche Fehler zusammen mit der vom Decoder gewählten Korrektur eine nichttriviale Kette zwischen passenden Grenzen bzw. um eine topologische Schleife bildet. Deshalb wächst der Schutz mit dem Codeabstand.
Memo-Mantra
Lange Fehlerketten sind die Gefahr; Topologie macht lokale Störungen korrigierbar.
10.4 Eastin-Knill-Theorem & Magic State Distillation
Experten-Ebene
Das Eastin–Knill-Theorem schließt für endlichdimensionale Quantencodes ein universelles Set rein transversaler logischer Gatter aus. Fault-Toleranz kann dennoch durch zusätzliche Verfahren erreicht werden, etwa Magic-State-Distillation/Injection, Code Switching oder Gauge Fixing.
Für Dummies
Kein einzelner Code kann alle benötigten logischen Gatter einfach transversal und zugleich universell bereitstellen. Magic States sind ein wichtiger Ausweg, aber nicht der einzige.
Memo-Mantra
Eastin–Knill setzt transversal Grenzen klar; Universalität braucht zusätzliche Verfahren – das ist wahr.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Syndrom-Berechnung im 3-Qubit-Bit-Flip-Code):
Der 3-Qubit-Bit-Flip-Code codiert ein logisches Qubit in n=3 physische Qubits. Gegen reine X-/Bit-Flip-Fehler wirkt er wie ein Repetitionscode mit Abstand 3 und korrigiert einen einzelnen Bit-Flip. Als vollständiger Quantencode gegen beliebige Pauli-Fehler hat er jedoch Distanz 1, weil er Phasenfehler nicht schützt.
Code-Basis: , .
Die Stabilizer-Generatoren lauten:
Angenommen, auf Qubit 1 tritt ein Bit-Flip-Fehler auf:
Der gestörte Zustand sei .
Wir messen die Stabilizer-Generatoren an :
Messung von :
Eigenwert = (Fehler schlägt an!).
Messung von :
Eigenwert = (Kein Fehler zwischen Qubit 2 und 3).
Syndrom-Vektor: Eindeutiges Fehlersyndrom für ein Bit-Flip auf physischem Qubit 1.
Modul 11 · Tensor-Netzwerke & Vielteilchen-Quantensysteme
Tensor-Netzwerke komprimieren bestimmte Vielteilchenzustände, wenn ihre Verschränkungsstruktur eine moderate Bond-Dimension erlaubt. Für gapped lokale 1D-Systeme ist ein Area Law rigoros bewiesen; MPS und DMRG nutzen genau diese Struktur besonders erfolgreich.
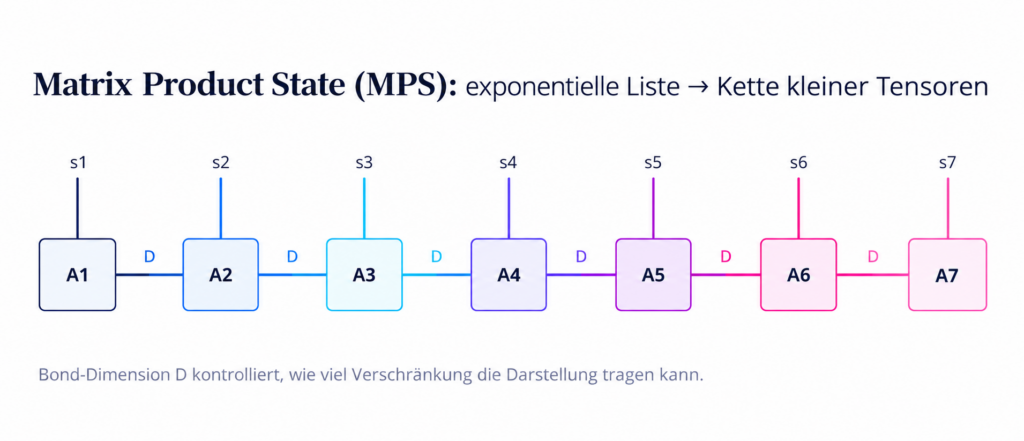
Terminologie Area Law vs. Volume Law, Matrix Product State (MPS), Bond-Dimension , Singularwertzerlegung (SVD), DMRG, PEPS, Schmidt-Trunkierung.
11.1 Area Law der Verschränkungsentropie
Experten-Ebene
Für eindimensionale lokale Quantensysteme mit endlicher lokaler Dimension und einer nichtverschwindenden Spektrallücke ist unter den üblichen Annahmen ein Area Law für die Verschränkungsentropie von Grundzuständen rigoros bewiesen. In 1D bedeutet „Area“: Die Entropie eines Intervalls bleibt durch seine Randstruktur kontrolliert und wächst nicht proportional zu seiner Länge. In höheren Dimensionen ist ein allgemeines Area-Law-Theorem wesentlich schwieriger und nicht in derselben Allgemeinheit verfügbar.
Für Dummies
Für 1D-Systeme mit Energielücke ist mathematisch gut verstanden, warum die Verschränkung vieler Grundzustände nicht mit dem gesamten Volumen explodiert. Für höhere Dimensionen muss man vorsichtiger formulieren.
Memo-Mantra
Im gapped 1D-Grundzustand gilt meist klar: Entropie folgt der Grenze – Area Law ist da.
11.2 Matrix Product States (MPS)
Experten-Ebene
Jeder endliche 1D-Zustand kann formal als Matrix Product State dargestellt werden, im schlechtesten Fall jedoch mit exponentiell großer Bond-Dimension D. Der praktische Gewinn entsteht, wenn der relevante Zustand mit moderatem D gut approximiert werden kann.
Für Dummies
Eine MPS ist nicht automatisch klein. Theoretisch kann sie jeden 1D-Zustand darstellen – dann kann D aber riesig werden. Praktisch spannend wird sie, wenn ein kleineres D schon fast alles Wichtige erfasst.
Memo-Mantra
MPS ersetzt die lange Liste durch Ketten klein; effizient wird es bei moderatem D sein.
11.3 SVD-Trunkierung & Schmidt-Rang
Experten-Ebene
SVD-Trunkierung & Schmidt-Rang: Ordne die Schmidt-Koeffizienten λ₁≥λ₂≥… und behalte die D größten. Für den unnormalisierten truncierten Zustand |ψ_D⟩ gilt exakt ‖|ψ⟩−|ψ_D⟩‖² = ∑_{k>D} λ_k². Die verworfene Summe der quadrierten Schmidt-Koeffizienten kontrolliert also direkt den lokalen Trunkierungsfehler.
Für Dummies
Der mathematische MP3-Komprimierer: Über die Singularwertzerlegung sortiert man die Komponenten nach ihrer Bedeutung. Kleine, unwichtige Verschränkungs-Anteile schneidet man einfach ab – genau wie bei einer MP3-Datei, die unhörbare Frequenzen löscht.
Memo-Mantra
SVD sortiert nach Gewicht im Band; kleine Schmidt-Werte kürzt man kontrolliert am Rand.
11.4 DMRG & PEPS
Experten-Ebene
DMRG & PEPS: Die Density Matrix Renormalization Group (DMRG) ist ein variationelles Verfahren zur Approximation von Grundzuständen innerhalb der Klasse der Matrix Product States. Durch lokale Optimierung der Tensoren wird die Variationsenergie minimiert; eine Garantie, stets das globale Minimum zu finden, besteht im Allgemeinen nicht. Die natürliche Verallgemeinerung der Tensor-Netzwerk-Idee von 1D auf 2D führt zu Projected Entangled Pair States (PEPS).
Für Dummies
Der Suchscheinwerfer im Vielteilchenraum: DMRG optimiert die MPS-Tensoren schrittweise und senkt dabei die Variationsenergie. In der Praxis ist das für viele 1D-Probleme äußerst erfolgreich, garantiert aber nicht in jeder Situation das globale Minimum. PEPS erweitert diese Idee auf ein zweidimensionales Netz.
Memo-Mantra
DMRG sucht im MPS-Raum nach Energie klein; PEPS trägt die Idee ins zweidimensionale Netz hinein.
Rechenbeispiel & Anwendung
Experten-Ebene · Rechnung
Basisbeispiel (Speicher-Kompressions-Verhältnis für Qubits):
Ein voller Quantenzustand auf Qubits erfordert einen Koeffizientenvektor im Hilbertraum .
Speicherbedarf der exakten Darstellung:
Anzahl Amplituden: komplexe Zahlen.
Exakter Speicheraufwand: Unmöglich auf klassischen Computern speicherbar.
Speicherbedarf der MPS-Approximation mit Bond-Dimension :
Eine MPS-Kette mit offenen Randbedingungen besteht aus Tensoren der Form mit physikalischer Indexdimension (Qubit).
Parameteranzahl pro Tensor: .
Gesamte Parameteranzahl für Tensoren:
Dimensions- & Einheiten-Analyse:
Exakt: Exponentielles Wachstum .
MPS: Lineares Wachstum in der Systemgröße .
Einheiten: Reine Skalare (komplexe Koeffizienten).
Fazit: Für Zustände, die mit moderater Bond-Dimension gut approximierbar sind, kann die Reduktion von auf Parametern die klassische Berechnung dramatisch vereinfachen; für stark verschränkte Zustände kann der Vorteil jedoch verschwinden.
Vertiefung A · Der adjungierte Operator im Skalarprodukt
Diese Vertiefung bündelt die Verschiebungsregel, die in fast allen späteren Rechnungen wiederkehrt. Sie ist gleichzeitig die Brücke zu Hermizität, Unitarität und zum Wechsel zwischen Schrödinger- und Heisenberg-Bild.
A.1 Definition & Seitenwechsel
Experten-Ebene
In der Physik-Konvention ⟨x|y⟩=x†y ist A† eindeutig durch ⟨Ax|y⟩=⟨x|A†y⟩ definiert. Äquivalent gilt ⟨x|Ay⟩=⟨A†x|y⟩. Für Matrizen in einer Orthonormalbasis ist A†=(Ā)ᵀ.
Für Dummies
Ein Operator darf im Skalarprodukt die Seite wechseln – aber nicht unverändert. Beim Wechsel bekommt er das Dagger †. Genau diese Regel verhindert Vorzeichen- und Konjugationsfehler.
Memo-Mantra
Wechselt A die Seite im Produkt, kommt † dazu – exakt und gut.
A.2 Kurzer Matrixbeweis
Experten-Ebene
⟨Ax|y⟩ = (Ax)†y = x†A†y = ⟨x|A†y⟩. Der Beweis ist in endlichen Dimensionen nichts anderes als die Rechenregel (Ax)†=x†A† plus Assoziativität der Matrixmultiplikation.
Für Dummies
Man schreibt das Skalarprodukt als Zeilenvektor mal Spaltenvektor. Beim Adjungieren eines Produkts kehrt sich die Reihenfolge um – deshalb landet A als A† auf der anderen Seite.
Memo-Mantra
Produkt adjungiert? Reihenfolge dreht – so wird A† korrekt verspäht.
A.3 Warum das in Quanteninformation ständig auftaucht
Experten-Ebene
Für unitäres U gilt U†U=I, daher ||Uψ||²=⟨ψ|U†U|ψ⟩=||ψ||². Für hermitesches A=A† ist ⟨ψ|A|ψ⟩ reell. Außerdem folgt ⟨Uψ|A|Uψ⟩=⟨ψ|U†AU|ψ⟩ – die algebraische Grundlage des Heisenberg-Bildes.
Für Dummies
Mit derselben Dagger-Regel beweist man drei Dinge auf einmal: Quantengatter erhalten Normen, Observablen liefern reelle Erwartungswerte, und man kann die Zeitentwicklung vom Zustand auf das Messgerät „umschieben“.
Memo-Mantra
U†U macht Normen rein; A=A† macht Messwerte reell und fein.
Vertiefung B · Quantengatter, Unitarität & Schrödinger-Gleichung
Hier wird die zentrale Synthese sichtbar: Ein hermitescher Energieoperator erzeugt über die Exponentialabbildung eine unitäre Zeitentwicklung.
B.1 Was ein Quantengatter mathematisch ist
Experten-Ebene
Ein ideales n-Qubit-Gatter ist ein unitärer Operator U∈U(2ⁿ). Unitär bedeutet U†U=I. Für ein einzelnes Qubit entspricht U – nach Herausfaktorisieren einer globalen Phase – einer Rotation der Bloch-Kugel. „Spiegelung“ ist daher als geometrisches Bild meist weniger präzise als „unitäre Isometrie/Rotation“.
Für Dummies
Ein Quantengatter darf den Zustand drehen und Phasen verändern, aber es darf seine Norm nicht zerquetschen. Bei einem Qubit sieht die physikalisch relevante Wirkung wie eine Rotation der Bloch-Kugel aus.
Memo-Mantra
Unitär heißt: drehen ohne Verlust – die Norm bleibt eins, ganz bewusst.
B.2 Von der Differentialgleichung zum Exponential
Experten-Ebene
Für zeitunabhängiges H lautet die Schrödinger-Gleichung iħ d|ψ⟩/dt = H|ψ⟩. Die Lösung ist |ψ(t)⟩=U(t)|ψ(0)⟩ mit U(t)=exp(−iHt/ħ). Das Matrixexponential ist durch die Potenzreihe exp(X)=Σₖ Xᵏ/k! definiert.
Für Dummies
Wie bei y′=ay entsteht aus einer konstanten Änderungsregel eine Exponentialfunktion. Nur ist a hier eine Matrix – und der Faktor −i/ħ sorgt dafür, dass aus Energie eine Phasenbewegung wird.
Memo-Mantra
Konstantes H im Zeitverlauf – das Matrix-e schreibt U(t) auf.
B.3 Warum hermitesches H unitäres U erzeugt
Experten-Ebene
Aus H†=H folgt U(t)†=exp(+iHt/ħ). Da H mit sich selbst kommutiert, gilt U†U=exp(+iHt/ħ)exp(−iHt/ħ)=I. Lie-theoretisch ist −iH/ħ schiefhermitesch und damit ein Element von 𝔲(d); die Exponentialabbildung führt nach U(d).
Für Dummies
Hermitesch plus der Faktor −i macht aus H einen „reinen Drehgenerator“. Das Exponential läuft deshalb auf der unitären Gruppe und kann keine Norm verlieren.
Memo-Mantra
Hermitescher Motor, −i dabei – macht die unitäre Fahrt verlustfrei.
B.4 Vom Energie-Eigenwert zur Phasenrotation
Experten-Ebene
Ist H|E⟩=E|E⟩, dann wirkt die Zeitentwicklung auf denselben Eigenvektor als U(t)|E⟩=e^(−iEt/ħ)|E⟩. Der reelle Energieeigenwert E wird durch die Exponentialabbildung zu einem unitären Eigenwert auf dem komplexen Einheitskreis.
Für Dummies
Der Hamiltonian sagt im Eigenzustand: „Deine Energie ist E.“ Die Zeitentwicklung übersetzt dieses E in eine laufende Phase. Der Zustand wird nicht länger oder kürzer – er sammelt Phase.
Memo-Mantra
E ist reell im Hamiltonian drin, e^(−iEt/ħ) dreht die Phase hin.
Vertiefung C · Drei äquivalente Bilder der Quantendynamik
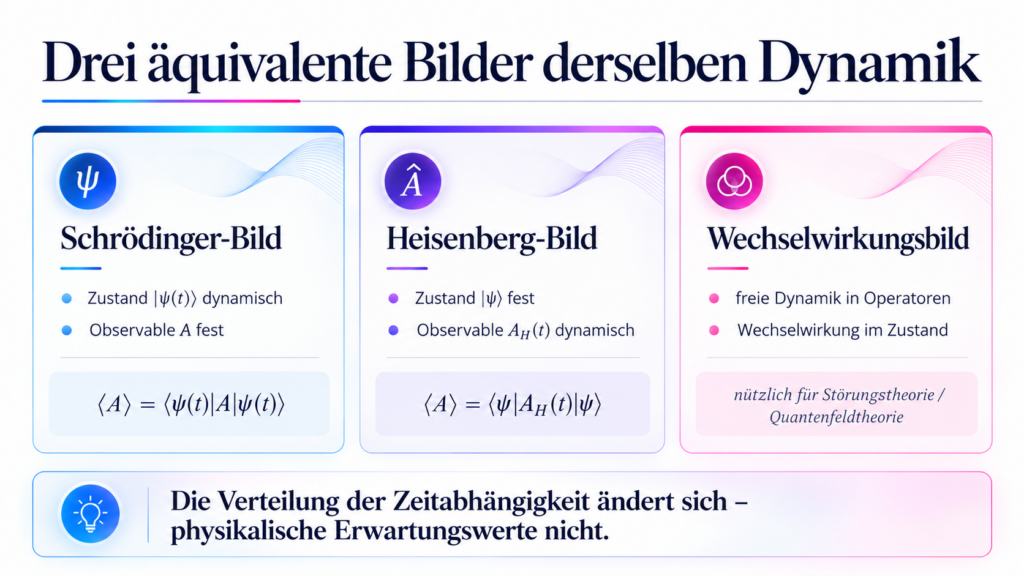
Schrödinger-, Heisenberg- und Wechselwirkungsbild sind keine drei verschiedenen Physiken. Sie verteilen dieselbe Zeitabhängigkeit unterschiedlich auf Zustände und Operatoren. Erwartungswerte stimmen überein.
C.1 Schrödinger-Bild
Experten-Ebene
Der Zustand trägt die Dynamik: iħ ∂ₜ|ψ_S(t)⟩=H_S|ψ_S(t)⟩ und |ψ_S(t)⟩=U(t)|ψ_S(0)⟩. Eine Observable A_S ohne explizite Zeitabhängigkeit bleibt als Operator fest. Erwartungswert: ⟨A⟩(t)=⟨ψ_S(t)|A_S|ψ_S(t)⟩.
Für Dummies
Die Kamera bleibt stehen, der Zustand bewegt sich. Das Messgerät ist in der Rechnung fest, während der Zustandsvektor die gesamte Zeitentwicklung trägt.
Memo-Mantra
Im Schrödinger-Bild bewegt sich der Zustand fort; der Operator bleibt am selben Ort.
C.2 Heisenberg-Bild
Experten-Ebene
Der Zustand wird auf den Referenzzeitpunkt fixiert. Die Observable entwickelt sich als A_H(t)=U†(t)A_SU(t). Für zeitunabhängiges H gilt dA_H/dt=(i/ħ)[H_H,A_H]+(∂A/∂t)_H. Erwartungswerte sind identisch zum Schrödinger-Bild.
Für Dummies
Jetzt hält man den Zustand fest und lässt stattdessen das Messgerät mathematisch mit der Zeit mitlaufen. Die Perspektive wechselt – die messbare Zahl nicht.
Memo-Mantra
Heisenberg hält den Zustand still; der Operator trägt die Zeit, wie er will.
C.3 Wechselwirkungsbild
Experten-Ebene
Schreibe H=H₀+V. Definiere |ψ_I(t)⟩=e^(+iH₀t/ħ)|ψ_S(t)⟩ und V_I(t)=e^(+iH₀t/ħ)V e^(−iH₀t/ħ). Dann gilt iħ ∂ₜ|ψ_I⟩=V_I(t)|ψ_I⟩. Das Bild ist besonders nützlich für Störungstheorie und die Dyson-Reihe, auch in der Quantenfeldtheorie.
Für Dummies
Man teilt die Arbeit: Die bekannte „freie“ Bewegung wird herausgerechnet; im Zustand bleibt vor allem das übrig, was durch die Wechselwirkung zusätzlich passiert.
Memo-Mantra
H₀ läuft frei, V greift ein – so kann das Wechselwirkungsbild hilfreich sein.
Wichtige Präzisierung zur Relativität Das Wechselwirkungsbild macht eine Theorie nicht automatisch Lorentz-kovariant. In relativistischer Quantenfeldtheorie wird es vor allem als Rechenbild für Störungstheorie verwendet. Eine kovariantere Verallgemeinerung der Schrödinger-Evolution ist beispielsweise die Tomonaga–Schwinger-Gleichung auf raumartigen Hyperflächen.
Fachliche Referenzen & Weiterlernen
Die Ausgangsdokumente wurden zu einem einheitlichen Lernpfad zusammengeführt und an mehreren Stellen fachlich präzisiert. Für die zentralen Aussagen wurden insbesondere folgende Primär- bzw. Lehrquellen gegengeprüft:
[1] Huang, H.-Y.; Kueng, R.; Preskill, J. (2020): Predicting many properties of a quantum system from very few measurements. Nature Physics 16, 1050–1057. DOI: 10.1038/s41567-020-0932-7. Online aufrufen
[2] IBM Quantum Learning: General Formulation of Quantum Information – Density Matrices, Bloch Sphere, Multiple Systems, Quantum Channels und General Measurements. Online aufrufen
[3] Preskill, J.: Quantum Information lecture notes, insbesondere Accessible Information / Holevo Bound. Online aufrufen
[4] Hastings, M. B. (2007): An Area Law for One Dimensional Quantum Systems. arXiv:0705.2024. Online aufrufen
[5] Schollwöck, U. (2011): The density-matrix renormalization group in the age of matrix product states. Annals of Physics 326, 96–192; arXiv:1008.3477. Online aufrufen
[6] Mugnolo, D.; Kerner, J.; Laasri, H. (2025): Funktionalanalysis. FernUniversität in Hagen, Version vom 2.3.2025. Ausgangspunkt des mathematischen Pre-Learnings dieses Skriptums. Online aufrufen
[7] Eastin, B.; Knill, E. (2009): Restrictions on transversal encoded quantum gate sets. Physical Review Letters 102, 110502. Online aufrufen
[8] Platon: Politeia, Buch VII, Höhlengleichnis (514a–517a). Hier ausschließlich als persönliche Denkmetapher für den Begriff „Shadows“, nicht als physikalische Herleitung. Online aufrufen
Verwandte Artikel
BEITRÄGE & PROJEKTE
Rationale Quantenmechanik
BEITRÄGE & PROJEKTE
VON DER IMAGINÄREN ZAHL ZUR BLOCH-KUGEL
BEITRÄGE & PROJEKTE
VIBE LEARNING: WAS HÄTTE LEONARDO DA VINCI MIT KI GEMACHT?
WEITERDENKEN
Quanten Learning mitdenken
Das Skriptum ist als lebendes Lernarchiv gedacht. Fragen, fachliche Hinweise und neue Verbindungen dürfen den Lernpfad weiterentwickeln.