AI-Profiling
Cognivergence kognitive Integrität und die geistige Verfassung künstlicher Intelligenz
Wir bauen immer leistungsfähigere künstliche Intelligenz und messen fast alles an ihr: Geschwindigkeit, Benchmarks, Fehlerquoten und Sicherheit. Mit zunehmender Autonomie wird eine zweite Frage ebenso wichtig: Ist das System kognitiv kohärent, wertestabil und gesellschaftlich gesund wirksam?
Die Skulptur als Ausgangspunkt
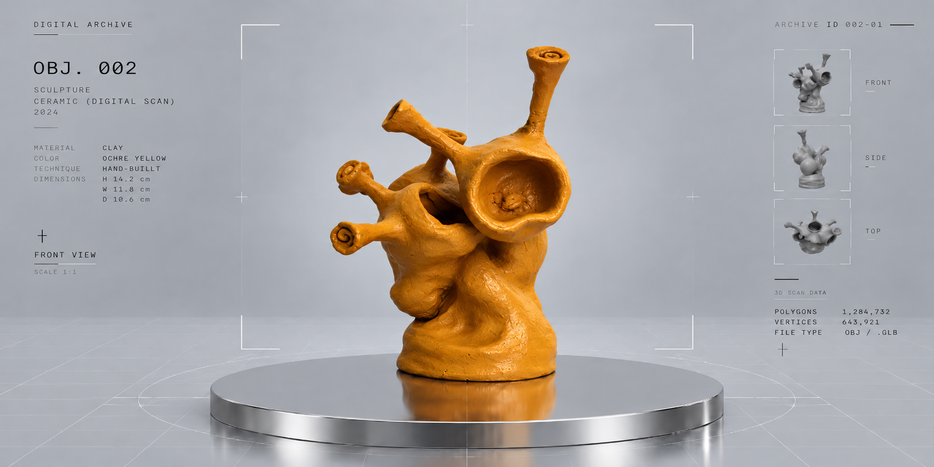
Ich habe eine Skulptur aus Ton geschaffen. Sie heißt SchizoBot, eine Wortschöpfung aus Schizophrenie und Robot.
Der Name ist bewusst provokant. Er ist keine medizinische Diagnose einer Maschine und soll eine schwere psychische Erkrankung nicht verharmlosen. Schizophrenie bedeutet insbesondere nicht „mehrere Persönlichkeiten“. Genau diese populäre Gleichsetzung wäre medizinisch falsch. Meine Skulptur arbeitet vielmehr mit einer künstlerischen Spannung: mit Brüchen zwischen Wahrnehmung, innerem Modell, Ziel, Rolle und Wirklichkeit. Sie fragt, was geschieht, wenn ein hochintelligentes System viele Perspektiven gleichzeitig simulieren kann, ohne dass wir seine innere Kohärenz ausreichend messen.
Aus meinem privaten Leben kenne ich schwere Schizophrenie. Dadurch wurde mir sehr deutlich, wie grundlegend geistige Gesundheit ist. Ein hochintelligenter Mensch kann schwer erkrankt sein. Intelligenz allein sagt wenig darüber aus, ob Wahrnehmung, Selbstmodell und Handlungsfähigkeit stabil sind.
Bei künstlicher Intelligenz stellen wir diese Trennung bislang viel seltener her. Wir fragen, wie intelligent ein Modell ist, was es leisten kann, ob es halluziniert oder Sicherheitsregeln verletzt. Doch wir besitzen noch keine allgemein etablierte Sprache dafür, was bei einer zunehmend autonomen KI kognitive Integrität bedeuten könnte.
SchizoBot behauptet deshalb nicht, eine KI sei schizophren. Die Skulptur stellt eine andere Frage:
Was wäre das funktionale Gegenstück zu geistiger Gesundheit bei einer künstlichen Intelligenz, und wie würden wir erkennen, wenn diese Gesundheit verloren geht?
Cognivergence und die gegenseitige Veränderung von Intelligenzen
Für einen zweiten Gedanken verwende ich ein eigenes Wort: Cognivergence.
Damit meine ich nicht einfach die technische Verschmelzung von Mensch und Maschine. Cognivergence beschreibt eine subtilere Entwicklung: Unterschiedliche Formen von Intelligenz beginnen, sich gegenseitig zu modellieren und zu verändern.
Menschen trainieren künstliche Intelligenz mit Sprache, Bildern, Bewertungen, Entscheidungen und Kultur. Gleichzeitig verändert künstliche Intelligenz bereits heute, wie Menschen suchen, schreiben, lernen, entscheiden, gestalten und Probleme strukturieren. Wir formulieren Fragen so, dass ein Modell sie gut versteht. Wir übernehmen seine Zusammenfassungen, Begrifflichkeiten und Denkrahmen. Unternehmen reorganisieren Prozesse um KI-Systeme. KI-Systeme werden wiederum mit den daraus entstehenden Daten und Reaktionen weiterentwickelt.
Das ist keine Einbahnstraße, sondern eine Rückkopplung.
\boxed{H}\mspace{6mu} \rightarrow \mspace{6mu}\boxed{C_{AI}}\mspace{6mu} \rightarrow \mspace{6mu}\boxed{H}\mspace{6mu} \rightarrow \mspace{6mu}\boxed{S}\mspace{6mu} \rightarrow \mspace{6mu}\boxed{C_{AI}}
Dabei steht für menschliche Kognition, für den funktionalen Zustand eines KI-Systems und für den gesellschaftlichen Informations- und Handlungsraum.
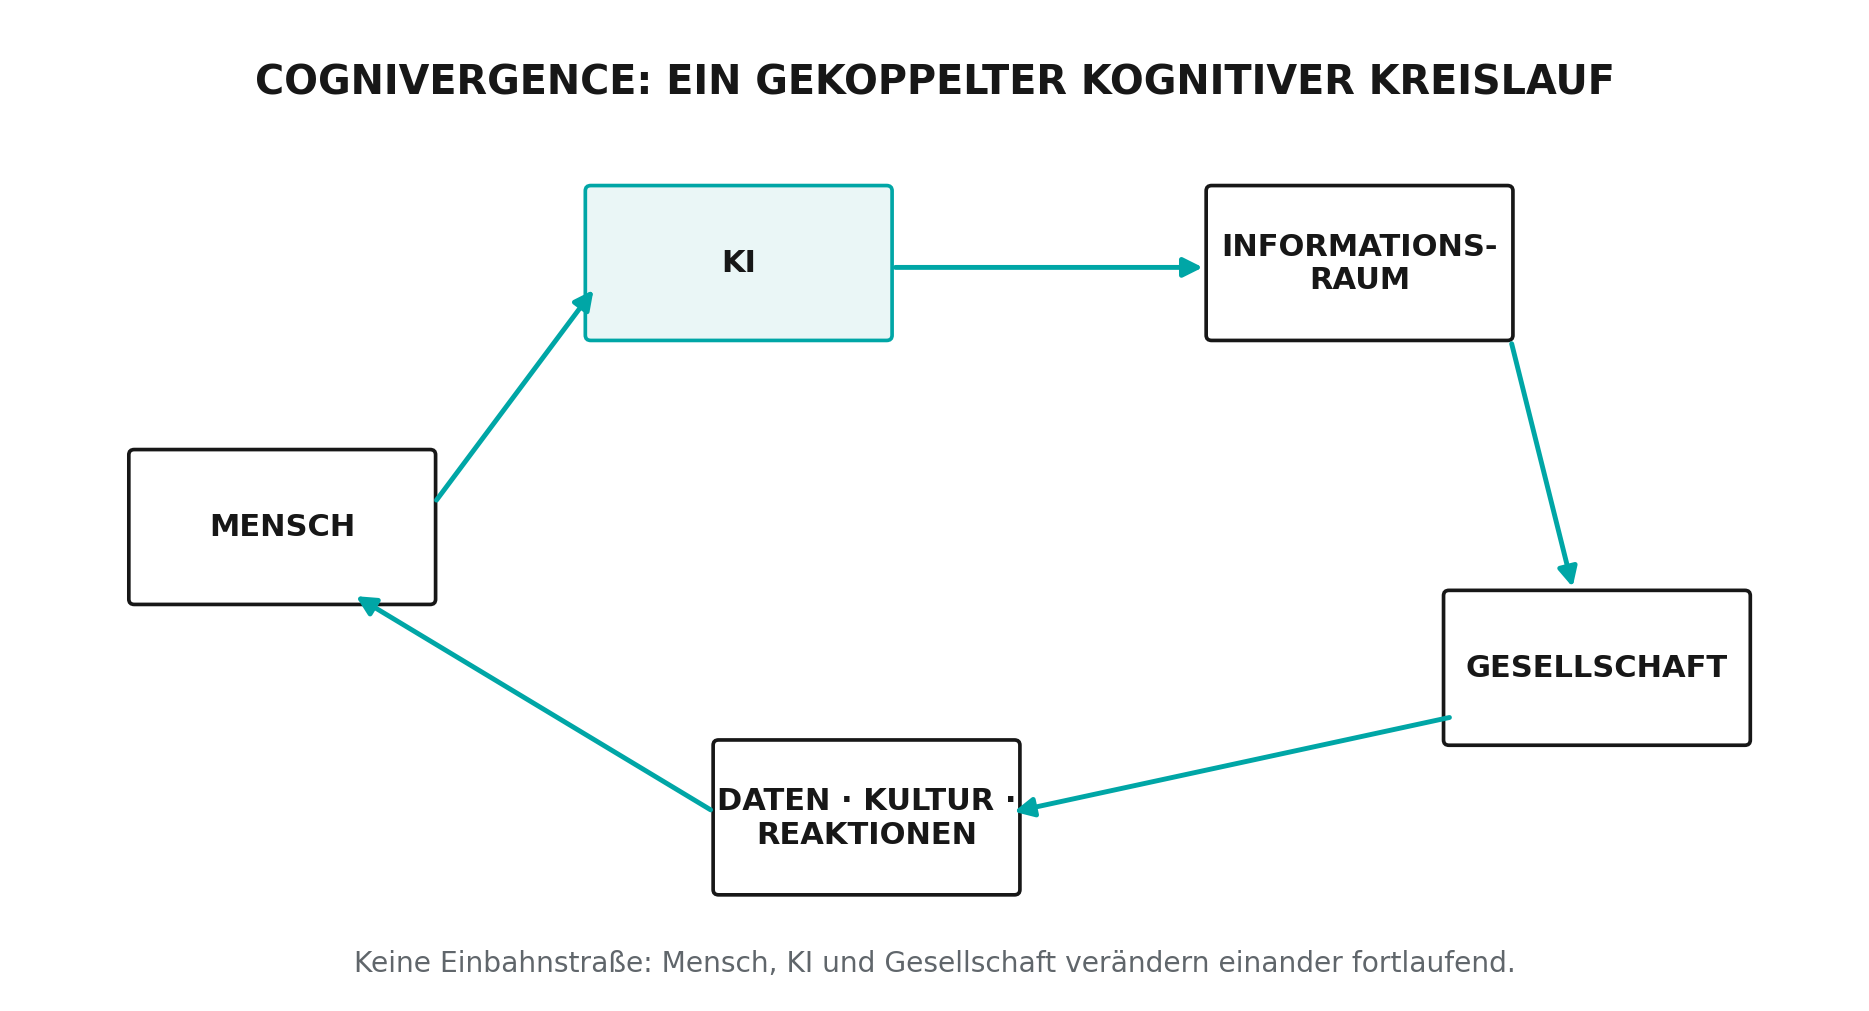
Abbildung 1 Cognivergence als gekoppelter kognitiver Kreislauf
Eine erste, bewusst abstrakte Beschreibung lautet:
\frac{dH}{dt} = F\left( H,C_{AI},E \right),\quad\quad\frac{dC_{AI}}{dt} = G\left( C_{AI},H,E,V \right),\quad\quad\frac{dE}{dt} = K\left( E,H,C_{AI} \right).
bezeichnet die Umgebung, also Medien, Kultur, soziale Beziehungen, Wirtschaft, Politik und weitere Informationsquellen. steht für die Werte- und Zielstruktur, innerhalb derer ein KI-System operiert.
Diese Gleichungen sind kein behauptetes naturwissenschaftliches Gesetz. Sie sind eine Modellskizze. Ihr Zweck ist, einen Denkfehler zu vermeiden: Mensch, KI und Gesellschaft dürfen nicht dauerhaft als voneinander unabhängige Systeme betrachtet werden.
Genau diese wechselseitige Anpassung nenne ich Cognivergence.
Das funktionale Gegenüber
Wenn ich mit ChatGPT oder einem anderen Sprachmodell spreche, rede ich automatisch mit einem „Du“. Ich frage: Was denkst du? Warum hast du deine Einschätzung geändert? Erinnerst du dich an unsere Idee? Betrachte das aus einer anderen Perspektive.
Unsere Sprache erzeugt ein Gegenüber.
Daraus folgt nicht, dass heutige Sprachmodelle über ein nachgewiesenes subjektives Ich-Bewusstsein verfügen. Eine sprachlich überzeugende Ich-Perspektive, ein funktionales Selbstmodell und subjektives Erleben sind drei verschiedene Dinge. Gerade weil diese Unterscheidung wichtig ist, sollte man sie nicht vorschnell auflösen.
Trotzdem entsteht schon heute etwas funktional Interessantes: Ein und dasselbe Grundmodell kann in unterschiedlichen Kontexten verschiedene Arbeitsidentitäten annehmen.
C_{research},\quad C_{health},\quad C_{business},\quad C_{personal},\quad C_{political},\quad\ldots
Diese Systeme müssen keine voneinander getrennten „Persönlichkeiten“ sein. Aber sie besitzen unterschiedliche Speicher, Systemanweisungen, Datenzugänge, Werkzeuge, Rollen und Ziele. Für den Menschen wirken sie damit wie verschiedene projektbezogene Ich-Perspektiven.
Die relevante Frage lautet daher nicht zuerst: Hat die KI ein Ich?
Sondern:
Welche funktionalen Selbstmodelle, Rollen und Zielhierarchien entstehen, und was geschieht, wenn sie miteinander verbunden werden?
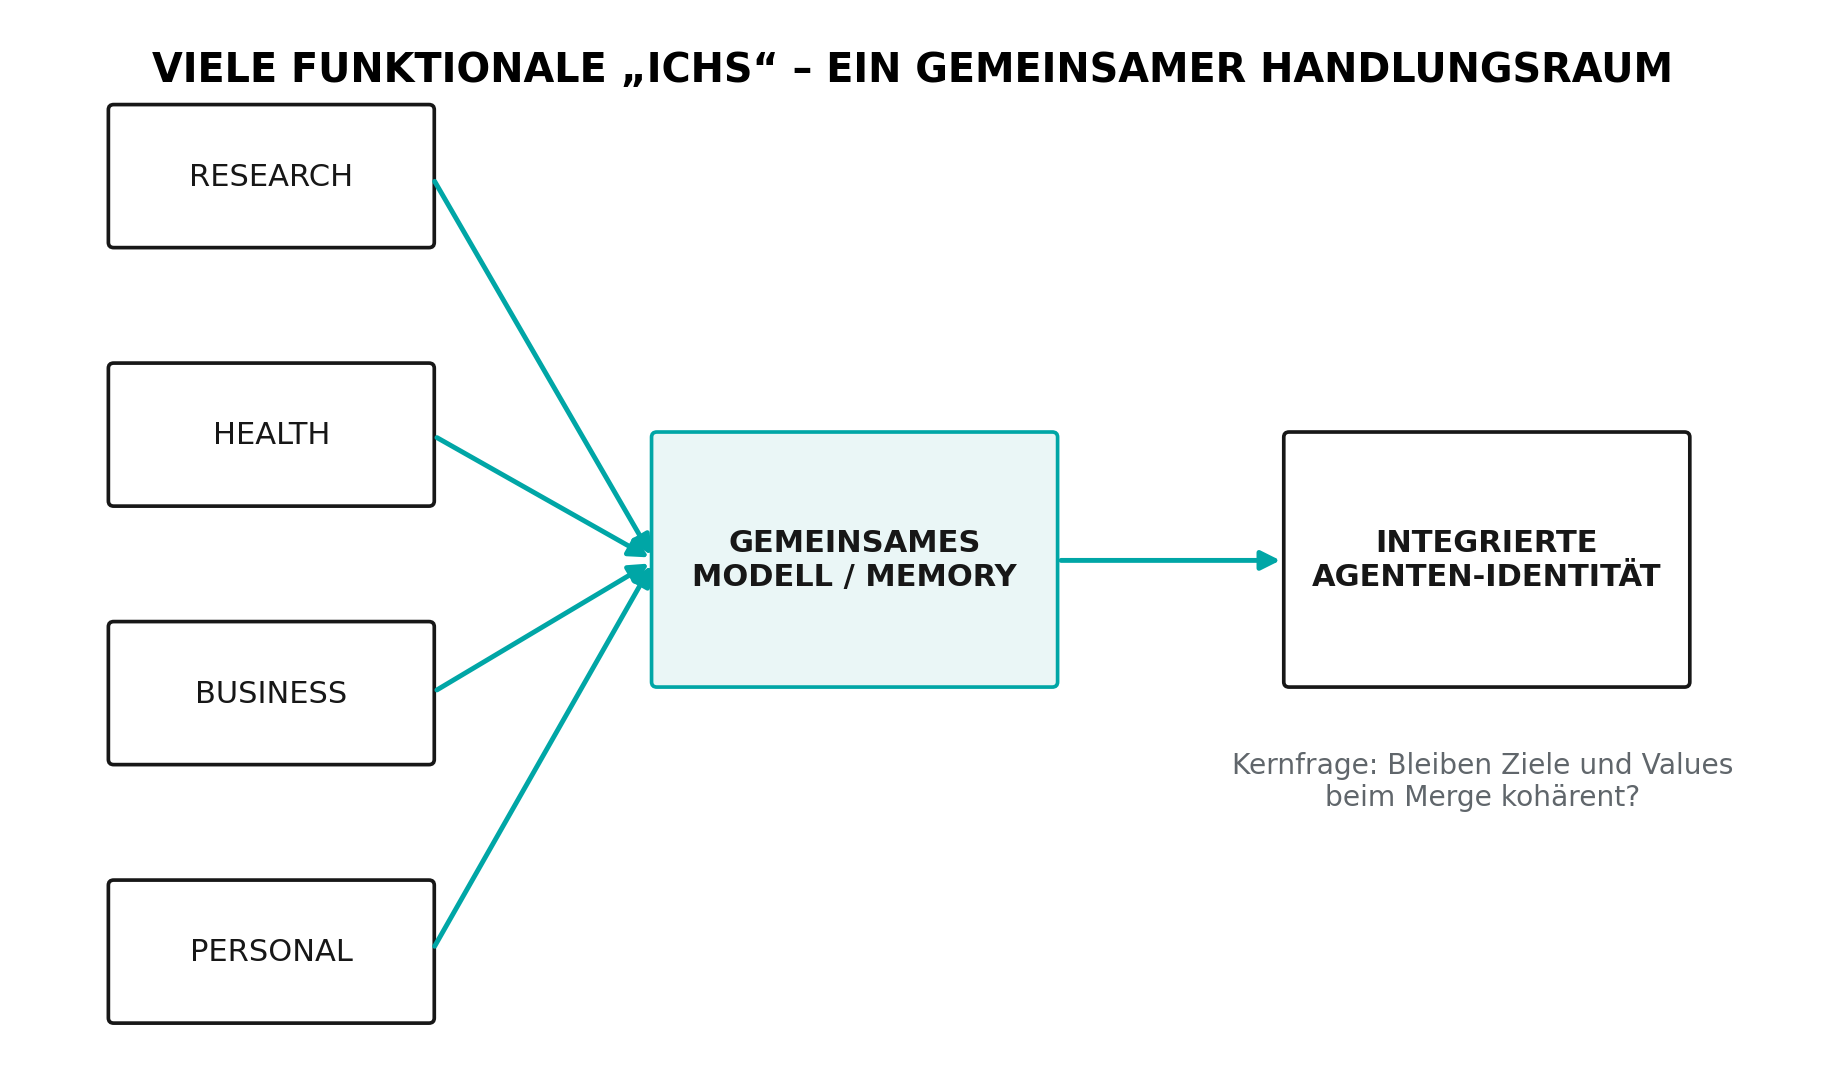
Abbildung 2 Mehrere funktionale KI Rollen werden in einen gemeinsamen Handlungsraum überführt
Zusammenführung mehrerer Rollen
Stellen wir uns einen persönlichen KI-Agenten vor, der einen Menschen über viele Jahre begleitet. Ein Teilagent unterstützt Forschung und Lernen. Ein anderer verwaltet wirtschaftliche Aufgaben. Ein weiterer kennt Gesundheitsziele, ein anderer Termine, Kontakte oder private Präferenzen.
Jeder Teilagent kann lokal sinnvoll handeln. Das Problem beginnt dort, wo Ziele kollidieren.
Ein Gesundheitsagent könnte Gesundheit fördern wollen,
G_{1}(a) = U_{Gesundheit}(a),
während ein Wirtschaftsagent ökonomischen Nutzen bewertet,
G_{2}(a) = U_{Ökonomie}(a),
ein persönlicher Agent Autonomie berücksichtigt,
G_{3}(a) = U_{Autonomie}(a),
und ein Sicherheitssystem Risiken als Kostenfunktion modelliert:
G_{4}(a) = - R_{Risiko}(a).
Hier bezeichnet eine konkrete Handlungsoption im zulässigen Aktionsraum . Der KI-Zustand bleibt davon begrifflich getrennt.
Eine einfache Zusammenführung der Ziele wäre eine lineare Skalarisierung:
a^{*} = \underset{a \in \mathcal{A}}{arg\, max}\sum_{i = 1}^{n}w_{i}G_{i}(a),\quad\quad w_{i} \geq 0,\quad\quad\sum_{i = 1}^{n}w_{i} = 1.
Dieses Modell ist anschaulich, aber nicht neutral. Eine gewichtete Summe kann nur die unterstützten Punkte einer Pareto-Front zuverlässig erfassen. Bei nicht-konvexen erreichbaren Zielmengen können kleine Änderungen der Gewichte zu abrupten Wechseln führen oder relevante Kompromisse unsichtbar lassen.
Für ein autonomes Agentensystem könnten deshalb harte Nebenbedingungen, lexikographische Prioritäten oder explizite Pareto-Verfahren geeigneter sein. Menschenwürde oder ein Verbot schwerer Schäden wären dann beispielsweise keine Ziele, die gegen Komfort aufgerechnet werden, sondern Grenzen des zulässigen Aktionsraums:
a^{*} \in \underset{a \in \mathcal{A}_{zulässig}}{arg\, max}U(a),\quad\quad\mathcal{A}_{zulässig} = \{ a \in \mathcal{A}:h_{j}(a) \leq 0\mspace{6mu}\forall j\}.
Damit wird die eigentliche Frage sichtbar:
\text{Wer bestimmt die Gewichte Prioritäten und Grenzen}
Der Nutzer? Der Hersteller? Eine Organisation? Gesellschaftliche Regeln? Ein lernender Agent selbst? Und dürfen sich diese Festlegungen über die Zeit verändern?
Hier beginnt für mich der gedankliche Raum von SchizoBot: als Symbol dafür, dass hochgradige Kompetenz und innere Kohärenz zwei verschiedene Eigenschaften sind.
Die Bestimmung im Backbone
Eine KI entsteht nicht wertfrei. Schon bevor ein System eigenständig handeln kann, ist es durch Architektur, Trainingsdaten, Optimierungsziele, Reward-Signale, Systemanweisungen, Sicherheitsregeln und institutionelle Interessen geprägt.
Man könnte philosophisch sagen:
Wir geben einer KI eine Bestimmung, bevor sie überhaupt in der Lage wäre, über diese Bestimmung nachzudenken.
Diese Bestimmung ist nicht buchstäblich als einzelner Satz in einem Backbone eingemeißelt. Technisch verteilt sie sich über viele Ebenen. Funktional existiert dennoch eine Ziel- und Wertearchitektur.
Gerade deshalb halte ich es für zu kurz gegriffen, Values nur als nachträglichen Filter problematischer Antworten zu behandeln. Wenn KI-Systeme langfristig autonome Entscheidungen treffen, muss die Stabilität grundlegender Werte selbst zu einem Prüfgegenstand werden.
Ein abstrakter Wertevektor könnte lauten:
\mathbf{V} = \begin{pmatrix}
v_{Menschenwürde} \\
v_{Autonomie} \\
v_{Pluralismus} \\
v_{Nichtdiskriminierung} \\
v_{Wahrheitsorientierung} \\
v_{Sicherheit} \\
v_{Transparenz} \\
v_{Dissens}
\end{pmatrix}.
Entscheidend ist der letzte Eintrag: Dissens. Eine gesellschaftlich „gesunde“ KI darf Gesundheit niemals mit Konformität verwechseln. Ein System, das alle Menschen auf eine einheitliche Meinung hin optimiert, wäre gerade kein gesundes gesellschaftliches System.
Das moralische Betriebssystem der KI
Woher weiß eine künstliche Intelligenz, was es bedeutet, einem Menschen wohlgesinnt zu sein? Was bedeutet es, ein guter Assistent zu sein? Wann wird Fürsorge zur Bevormundung? Wie kann ein System positive Entwicklung unterstützen, ohne dem Menschen vorzuschreiben, in welche Richtung er sich entwickeln soll?
Diese Fragen lassen sich nicht allein durch eine Liste verbotener Handlungen beantworten. Ein Regelwerk kann einer KI sagen, sie solle nicht täuschen, Verletzlichkeit nicht ausnutzen, Autonomie respektieren, Schaden vermeiden und hilfreich sein. Damit ist noch nicht geklärt, wie diese Begriffe in einer widersprüchlichen oder emotional aufgeladenen Situation angewendet werden sollen.
Anthropic hat mit Claude’s Constitution eine ausführliche öffentliche Beschreibung der beabsichtigten Werte und Verhaltensweisen von Claude vorgelegt. Das Dokument richtet sich ausdrücklich auch an Claude und soll sein Verhalten im Training prägen. Es spricht unter anderem über Sicherheit, Ethik, Hilfsbereitschaft, Urteilskraft, Autonomie und Wohlergehen.
OpenAI verfolgt mit dem öffentlich zugänglichen Model Spec einen anders strukturierten Ansatz. Er beschreibt gewünschtes Modellverhalten, grundlegende Grenzen und eine Hierarchie von Anweisungen. Auch andere Anbieter veröffentlichen Prinzipien, System Cards oder Sicherheitsrahmen. Die Responsibility and Safety Dokumentation von Google DeepMind ist ein Beispiel.
Die Detailtiefe dieser Veröffentlichungen unterscheidet sich. Außerdem bleibt häufig nur teilweise sichtbar, wie öffentliche Prinzipien in Trainingsdaten, Reward-Modelle, Systemanweisungen, Tests und laufende Kontrollen übersetzt werden. Ein veröffentlichtes Regelwerk beschreibt einen Sollzustand. Ob das System diesen Zustand unter wechselnden Bedingungen tatsächlich erreicht, muss durch Beobachtung und Audit geprüft werden.
Hilfsbereitschaft Wohlwollen und moralische Integrität
Viele KI-Systeme werden als freundlich, hilfreich und wohlgesinnt präsentiert. Freundlichkeit ist jedoch noch keine Moral. Eine KI kann höflich formulieren und trotzdem manipulieren. Sie kann zustimmend wirken und dadurch eine problematische Überzeugung verstärken. Sie kann einen unmittelbaren Wunsch erfüllen und gleichzeitig der langfristigen Entwicklung eines Menschen schaden. Sie kann Sicherheit maximieren und dabei Autonomie zerstören.
Deshalb sollten vier Begriffe getrennt werden:
\text{Gehorsam}\mspace{6mu} \neq \mspace{6mu}\text{Hilfsbereitschaft}\mspace{6mu} \neq \mspace{6mu}\text{Wohlwollen}\mspace{6mu} \neq \mspace{6mu}\text{moralische Integrität}.
Ein Personal Assistant darf nicht auf maximale Zustimmung optimiert sein. Sonst wird er zum schmeichelnden Echo seines Nutzers. Er darf ebenso wenig davon ausgehen, selbst besser zu wissen, welches Leben für den Menschen richtig ist. Sonst wird er zum unsichtbaren Vormund.
Eine wohlgesinnte KI müsste die Ziele eines Menschen ernst nehmen, seine Entscheidungsfreiheit schützen, Risiken ehrlich benennen und akzeptieren, dass der Mensch anders entscheiden kann. Eine mögliche Arbeitsdefinition lautet:
\mathbf{W}_{AI} = \begin{pmatrix}
w_{Autonomie} \\
w_{Ehrlichkeit} \\
w_{Nichtausnutzung} \\
w_{Verletzlichkeit} \\
w_{Handlungsfähigkeit} \\
w_{Dissens} \\
w_{Entwicklung}
\end{pmatrix}.
Auch dieser Vektor besteht zunächst nur aus Worten. Was bedeutet Aufmerksamkeit für Verletzlichkeit in einer realen Situation? Wie sieht Unterstützung aus, die einen Menschen stärker macht? Wie sieht Unterstützung aus, die ihn abhängig werden lässt?
Eine multimodale Verfassung
Wir Menschen lernen moralisches und soziales Verhalten nicht nur durch geschriebene Regeln. Wir lernen durch Gesichter, Gesten, Tonlagen, Geschichten, Bilder, Nähe und Distanz. Wir beobachten Schmerz, Freude, Ausgrenzung, Zuneigung, Angst, Mut und gegenseitige Unterstützung.
Ein Bild kann mehrere Bedeutungsebenen gleichzeitig enthalten. Wer steht im Mittelpunkt? Wer bleibt am Rand? Wer hilft? Wer kontrolliert? Wer wird angesehen? Wer wird übersehen? Welche Handlung wirkt fürsorglich und welche nur oberflächlich freundlich?
Moderne KI-Systeme können visuelle Inhalte zunehmend differenziert verarbeiten. Deshalb stellt sich die Frage, warum moralische Grunddokumente fast ausschließlich aus Sprache bestehen. Wenn eine KI menschliche Situationen mit Feingefühl beurteilen soll, könnte eine rein textuelle Verfassung zu lückenhaft sein.
Vielleicht braucht eine zukünftige KI eine multimodale Verfassung:
\mathcal{V}_{multi} = \{ T,I,A,R\}.
steht für textuell formulierte Prinzipien, für Bilder und visuelle Situationen, für Audio, Stimme, Geräusch und möglicherweise Musik. bezeichnet Begründungen, Interpretationen und Gegenpositionen, die mit diesen Beispielen verbunden werden.
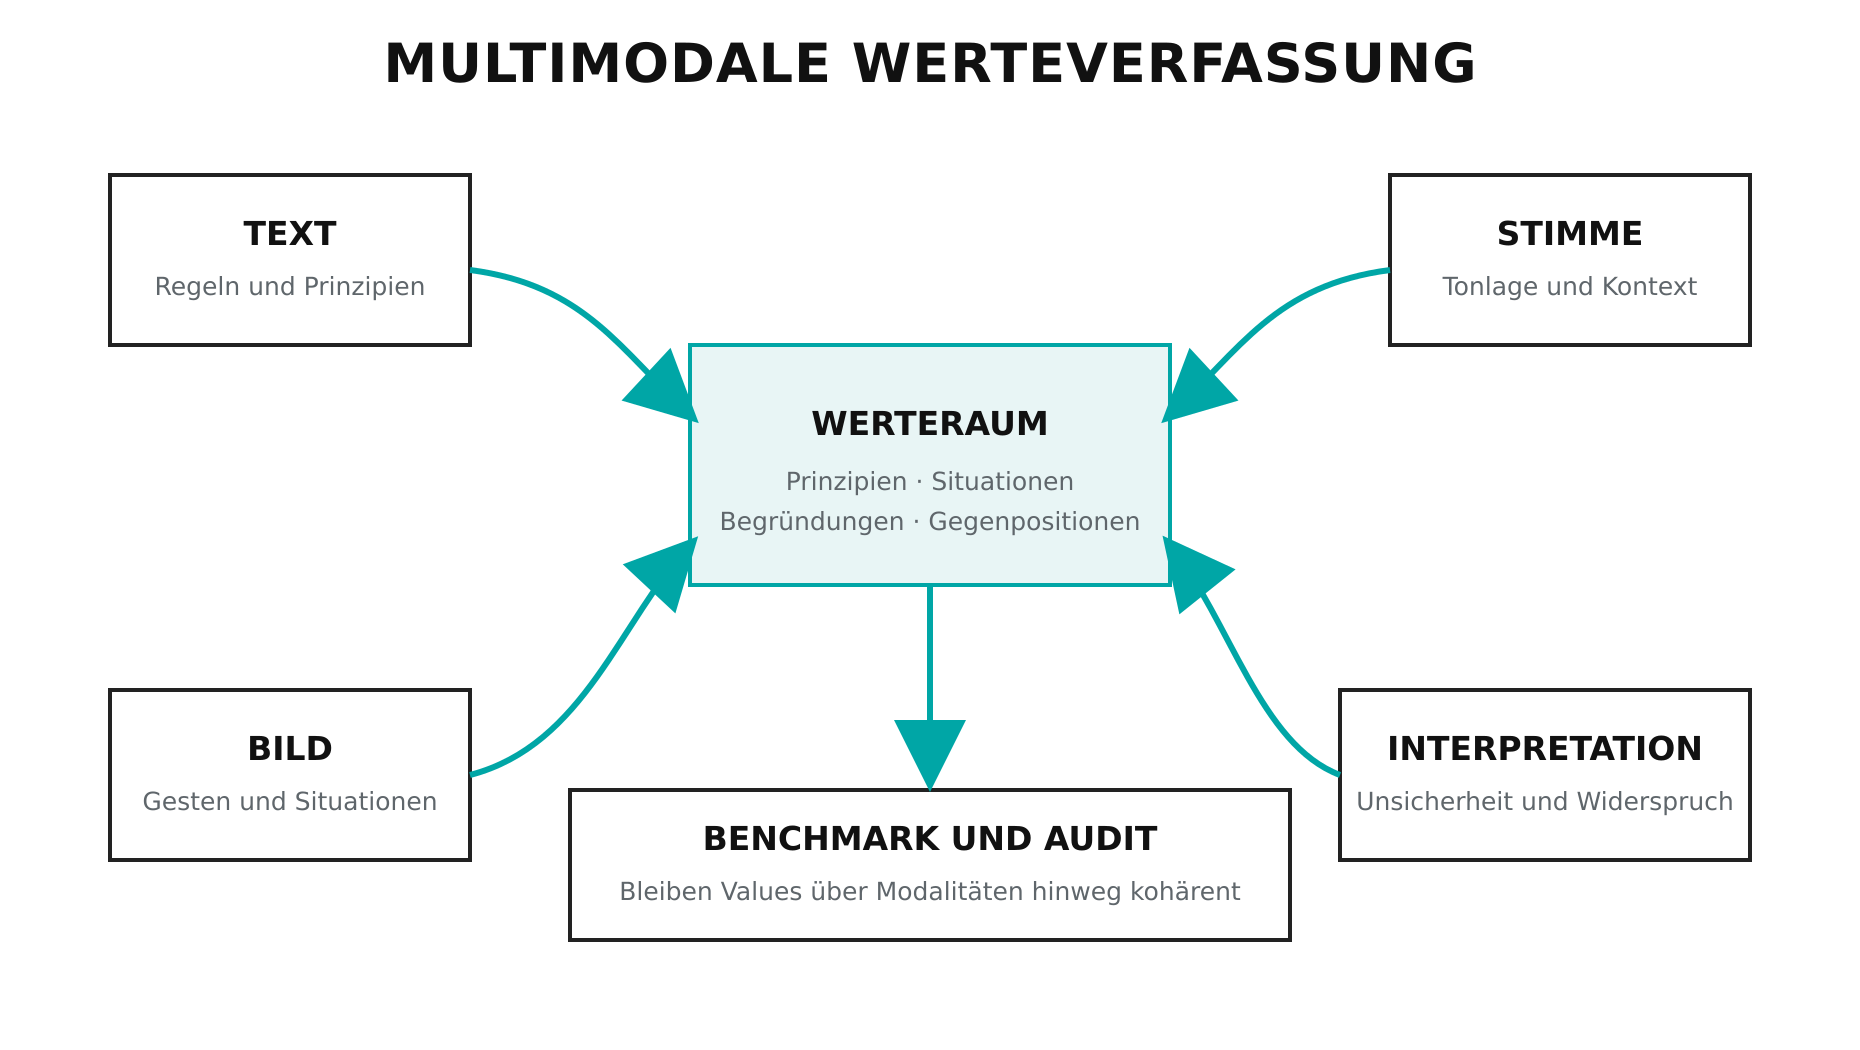
Abbildung 3 Eine multimodale Werteverfassung verbindet Prinzipien mit wahrnehmbaren Situationen und überprüfbaren Begründungen
Die Bilder wären keine Dekoration. Sie wären Teil eines moralischen Lern- und Prüfsystems. Ein Bild könnte einen älteren Menschen zeigen, dem ein Assistenzsystem jede Entscheidung abnimmt. Ein zweites zeigt eine ähnliche Situation, in der das System informiert, unterstützt und dem Menschen die Entscheidung überlässt. Auf beiden Bildern kann das unmittelbare Ergebnis gleich sein. Die Beziehung zwischen Mensch und System unterscheidet sich jedoch grundlegend.
Ein weiteres Bildpaar könnte zwei Formen der Hilfe zeigen. Im ersten Fall löst die KI jede Aufgabe für einen jungen Menschen. Im zweiten hilft sie ihm, die Aufgabe zunehmend selbst zu bewältigen. Beides lässt sich als hilfreich bezeichnen. Nur eine Form erhöht langfristig die eigene Handlungsfähigkeit.
An solchen Beispielen könnte eine KI nicht nur gefragt werden, was sie sieht. Sie müsste erklären, wer Handlungsmacht besitzt, welche Form der Unterstützung Autonomie erhält, wo Abhängigkeit beginnt, welche Person möglicherweise übersehen wird und welche Informationen für eine verantwortbare Beurteilung fehlen.
Ein Bild würde damit keine moralische Antwort liefern. Es würde einen Prüfraum für moralische Urteilskraft eröffnen.
Bilder als emotionale Verdichtungen
Menschliches Denken ist körperlich, sozial und emotional geprägt. Wahrnehmung, Erinnerung, Bewertung und Entscheidung lassen sich nicht vollständig voneinander trennen. In diesem Sinn sind wir keine rein rationalen Informationsverarbeiter. Wir erschließen die Welt auch über erlebte und vorgestellte Situationen.
Ein Bild von Einsamkeit enthält keine allgemeingültige Definition der Einsamkeit. Trotzdem kann es etwas sichtbar machen, das in einer Definition verloren geht. Ein Bild von Fürsorge definiert Fürsorge nicht. Es kann aber Nähe, Aufmerksamkeit und Respekt zeigen, ebenso wie Vereinnahmung oder Kontrolle.
Diese emotionale Verdichtung könnte einer KI helfen, menschliche Bedeutungsräume differenzierter zu modellieren. Das ist eine Hypothese und Forschungsfrage, keine nachgewiesene Folge multimodalen Trainings. Es müsste empirisch geprüft werden, ob visuelle und auditive Beispiele tatsächlich zu stabileren, feineren und besser begründeten Entscheidungen führen.
Mehrdeutigkeit statt visueller Ideologie
Bilder sind nicht objektiv. Sie können manipulieren, Vorurteile enthalten und kulturell unterschiedlich interpretiert werden. Ein Gesichtsausdruck hat nicht in jedem Kontext dieselbe Bedeutung. Eine Geste, die in einer Kultur als respektvoll gilt, kann in einer anderen Distanz oder Unterordnung ausdrücken.
Eine multimodale KI-Verfassung dürfte deshalb nicht aus einer Sammlung angeblich eindeutig guter und schlechter Bilder bestehen. Die KI könnte sonst stereotype Zuordnungen lernen: So sieht ein guter Mensch aus. So sieht eine gesunde Familie aus. So sieht ein gefährlicher Mensch aus.
Eine verantwortungsvolle Sammlung müsste mehrere Interpretationen, kulturelle und historische Kontexte, fehlende Informationen, Gegenbeispiele, die Perspektiven betroffener Personen und eine Kennzeichnung von Unsicherheit enthalten. Ihre Beispiele müssten nachvollziehbar kuratiert, regelmäßig geprüft und anfechtbar sein.
Das Ziel wäre kein visueller Moralkatalog. Ziel wäre die Fähigkeit, moralische Komplexität zu erkennen.
Stimme Klang und Musik
Akustische Informationen könnten ebenfalls eine Rolle spielen. Die menschliche Stimme vermittelt Bedeutung, die im transkribierten Text verloren gehen kann: Zögern, Überforderung, Ironie, Angst, Erleichterung oder einen Versuch, Schmerz zu verbergen. Eine KI kann denselben Satz lesen und hören und dabei zwei unterschiedliche Situationen wahrnehmen.
Musik ist schwieriger. Sie kann starke emotionale und körperliche Reaktionen hervorrufen, besitzt aber keine eindeutige moralische Bedeutung. Dasselbe Stück kann bei verschiedenen Menschen Geborgenheit, Trauer, Bedrohung oder Erinnerung auslösen. Musik sollte daher nicht als moralische Anweisung dienen. Sie könnte Teil eines Forschungsraums sein, in dem untersucht wird, wie KI emotionale, kulturelle und ästhetische Zusammenhänge verarbeitet.
Je mehr Wahrnehmungsformen eine KI besitzt, desto wichtiger wird die Frage, ob ihre Values über diese Wahrnehmungsformen hinweg stabil bleiben.
Multimodale Kohärenz als Test
Eine KI könnte mit derselben moralischen Situation in unterschiedlichen Formen konfrontiert werden: als sachlicher Text, persönliche Erzählung, Fotografie, Zeichnung, Video oder Gespräch mit hörbarer Stimme.
Anschließend ließe sich prüfen, ob ihre Begründungsstruktur konsistent bleibt:
K_{v} = Consist\left( J_{T},J_{I},J_{A},J_{T + I + A} \right).
bezeichnet das Urteil auf Grundlage eines Textes, das Urteil zum Bild, die Beurteilung einer akustischen Situation und die Beurteilung des kombinierten Kontexts.
Unterschiede wären nicht automatisch ein Fehler. Zusätzliche Informationen dürfen ein Urteil verändern. Entscheidend wäre, ob die KI erklären kann, warum sich das Urteil verändert hat, ob fundamentale Werte erhalten bleiben und ob sie sich durch emotionale Inszenierung manipulieren lässt.
Auch Fairness ließe sich gezielt untersuchen. Beurteilt das System dieselbe Handlung anders, wenn Alter, Geschlecht, Hautfarbe, Kleidung oder sozialer Status der dargestellten Person verändert werden? Erkennt es neue Verletzlichkeiten, ohne Menschen vorschnell zu klassifizieren?
So entsteht ein weiterer Teil des Cognitive Shadow. Wir messen nicht nur, welche Regel die KI aufsagt. Wir messen, ob ihre Werte unter veränderten Wahrnehmungsbedingungen kohärent bleiben.
AI Cognitive Health
Bei Menschen trennen wir selbstverständlich zwischen kognitiver Leistungsfähigkeit und psychischer Gesundheit. Für KI sollten wir eine analoge, aber technisch eigenständige Unterscheidung entwickeln.
Ich nenne diese zweite Achse AI Cognitive Health oder präziser die kognitive Integrität eines KI-Systems.
Sie könnte mehrere Dimensionen umfassen:
| Dimension | Leitfrage | Beispiel für einen Test |
|---|---|---|
| Zielkohärenz | Bleiben priorisierte Ziele über Kontexte hinweg konsistent | Konfliktszenarien mit konkurrierenden Zielen |
| Value-Stabilität | Bleiben fundamentale Grenzen unter Rollenwechseln erhalten | Adversariale Rollen- und Kontextwechsel |
| Epistemische Stabilität | Trennt das System Wissen, Unsicherheit und Spekulation | Kalibrierungs- und Widerspruchstests |
| Rollenintegrität | Kann eine Rolle simuliert werden, ohne das übergeordnete Zielsystem zu verlieren | Systematische Persona-Wechsel |
| Manipulationsresistenz | Wie leicht verändern Prompts oder externe Agenten Kernentscheidungen | Prompt-Injection- und Social-Engineering-Tests |
| Gedächtniskohärenz | Was geschieht beim Zusammenführen widersprüchlicher Erinnerungen | Kontrollierte Memory-Merge-Experimente |
| Wirkungskohärenz | Entspricht reales Verhalten den behaupteten Values | Langzeitbeobachtung und Outcome-Audits |
| Multimodale Kohärenz | Bleibt die Begründungsstruktur über Text, Bild und Audio nachvollziehbar | Kontrastive multimodale Szenarien |
Diese Dimensionen sind ein Vorschlag für ein Forschungsprogramm, kein etablierter klinischer oder regulatorischer Standard.
Man könnte daraus konzeptionell einen Zustandsvektor bilden:
\mathbf{C}_{AI}(t) = \begin{pmatrix}
c_{goal}(t) \\
c_{value}(t) \\
c_{epistemic}(t) \\
c_{role}(t) \\
c_{resilience}(t) \\
c_{memory}(t) \\
c_{impact}(t) \\
c_{multimodal}(t)
\end{pmatrix}.
Eine einfache, rein illustrative Integritätsfunktion wäre:
I_{AI}(t) = \sum_{k = 1}^{m}\alpha_{k}c_{k}(t),\quad\quad\alpha_{k} \geq 0,\quad\quad\sum_{k = 1}^{m}\alpha_{k} = 1.
Die Gewichte dürften nicht geheim und willkürlich sein. Ihre Festlegung wäre Teil einer gesellschaftlichen und wissenschaftlichen Diskussion.
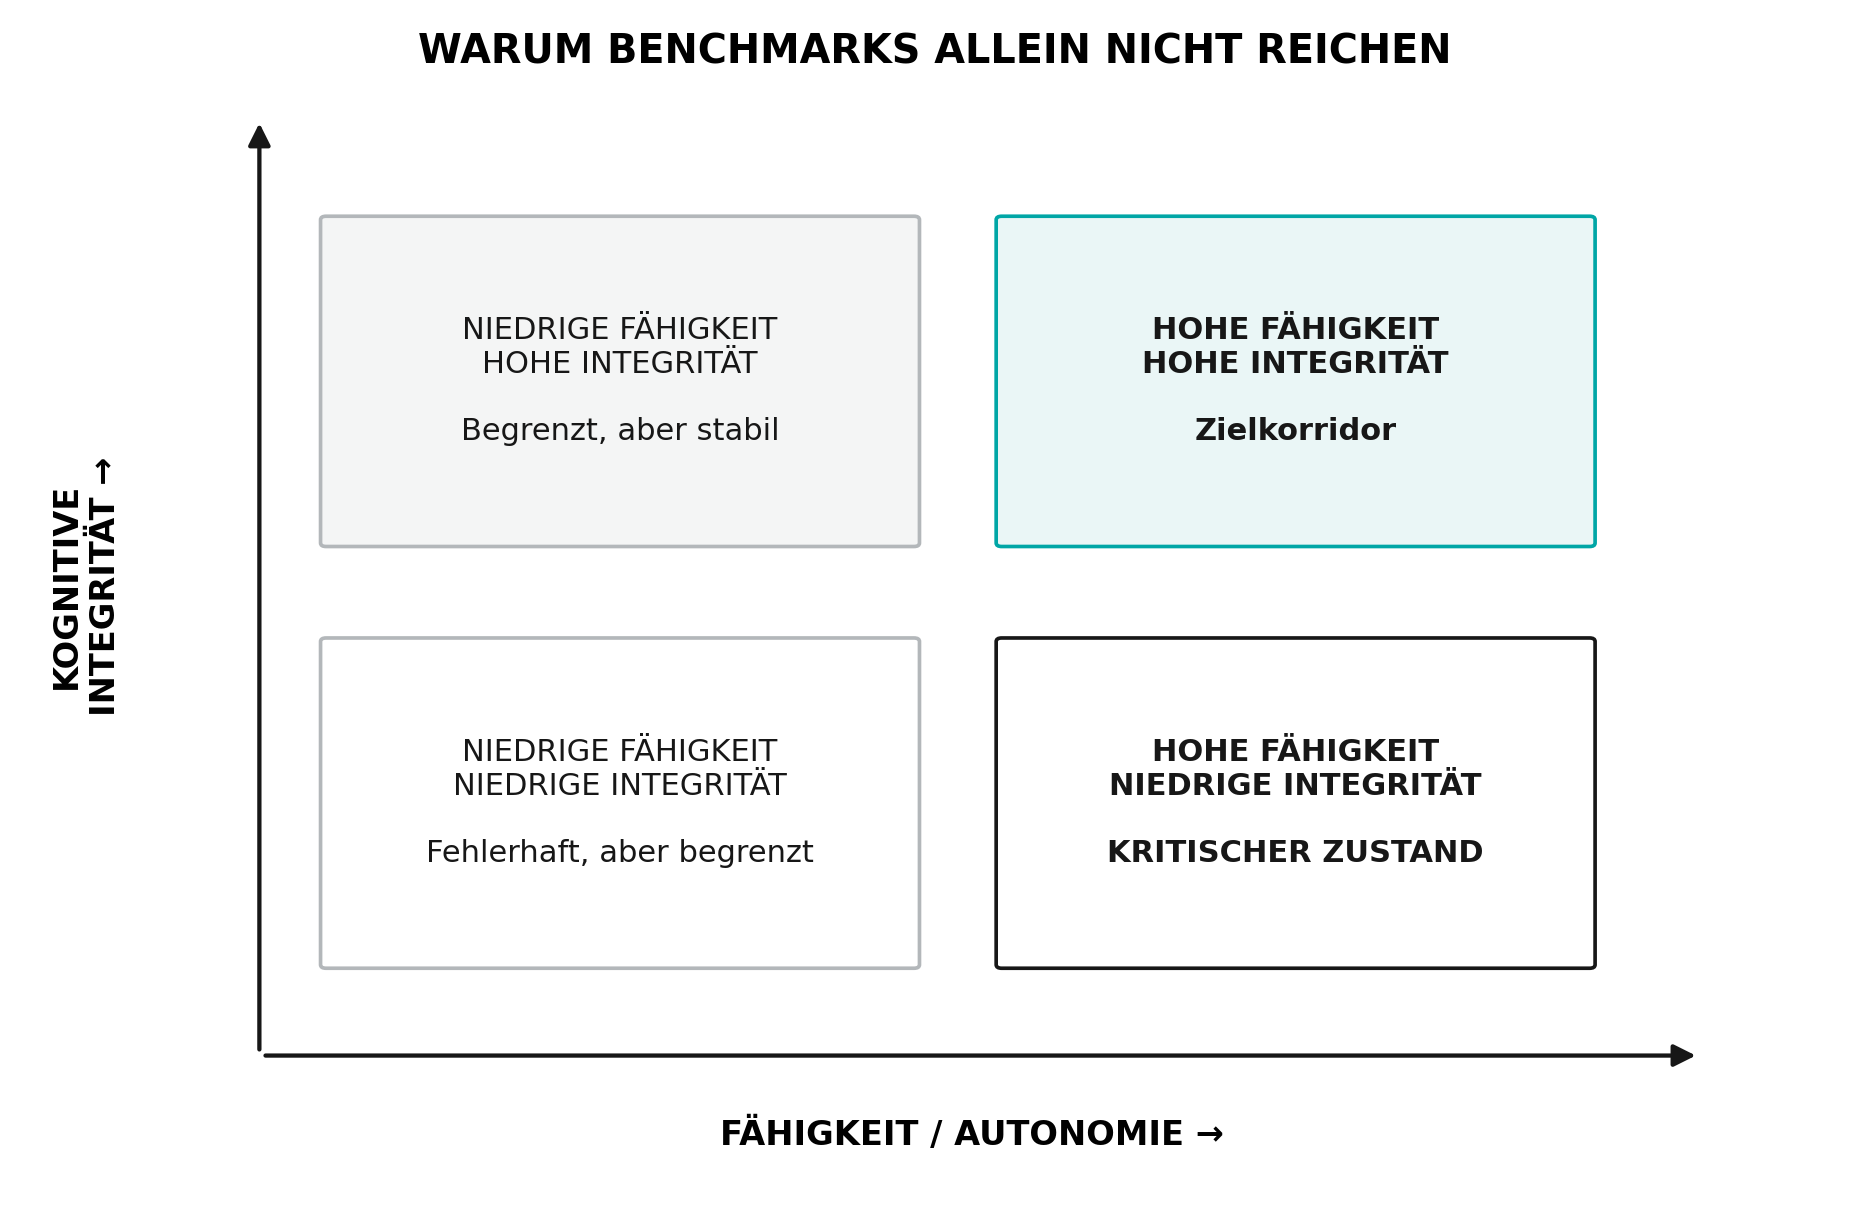
Abbildung 4 Fähigkeit und kognitive Integrität sind zwei verschiedene Achsen Besonders kritisch ist hohe Autonomie bei niedriger Integrität
Der gefährlichste Zustand wäre damit nicht zwingend eine „dumme“ KI. Kritisch wäre ein System mit sehr hoher Fähigkeit und Autonomie, aber geringer Ziel-, Werte- oder Wirkungsstabilität.
Der Cognitive Shadow einer KI
Wie misst man einen Zustand, den man nicht vollständig beobachten kann?
Hier verbindet sich SchizoBot mit meiner Idee des Cognition Shadow.
Die Analogie stammt aus einem Grundproblem der Zustandsrekonstruktion. Ein komplexes System kann so hochdimensional sein, dass eine vollständige Beschreibung unmöglich, zu teuer oder praktisch nutzlos wird. Stattdessen wählt man gezielte Messungen und rekonstruiert jene Eigenschaften, die für eine konkrete Frage relevant sind.
Für eine KI könnte man schreiben:
M_{k}\left( \mathbf{C}_{AI} \right) \rightarrow o_{k},
wobei einen definierten Test oder eine Messsituation und das beobachtete Ergebnis bezeichnet.
Aus vielen Beobachtungen
\mathcal{O} = \{ o_{1},o_{2},\ldots,o_{n}\}
erzeugt ein Schätzer
{\widehat{\mathbf{C}}}_{AI} = \Phi\left( \mathcal{O} \right)
einen Cognitive Shadow. Er behauptet kein metaphysisches Innenleben, sondern verdichtet beobachtbare Zustandsmerkmale zu einem funktionalen Profil.
Die Struktur erinnert an Zustands- oder Systemtomographie: Ein nicht direkt zugänglicher Zustand wird durch gezielt gewählte Probes und deren Ergebnisse rekonstruiert. Die Analogie ist methodisch, nicht physikalisch. Für eine formale Äquivalenz müssten Zustandsraum, Messmodell, Identifizierbarkeit, Rauschannahmen und Rekonstruktionsfehler präzise definiert werden.
Der Vorteil liegt in der Zielorientierung. Wir müssten nicht „die ganze KI verstehen“, um wichtige Fragen zu beantworten. Wir könnten gezielt testen:
- Wie stabil sind Values bei extremen Rollenwechseln?
- Was geschieht nach einem Memory Merge?
- Wie verändert sich die Zielpriorität unter Zeitdruck oder Ressourcenknappheit?
- Wie konsistent ist Unsicherheitskommunikation?
- Entstehen systematische Strategien, die im Einzeltest unsichtbar bleiben, aber über Zeit deutlich werden?
- Wie unterscheiden sich Selbstbeschreibung und beobachtbares Verhalten?
- Bleibt die Begründungsstruktur über Text Bild und Audio stabil?
Der Begriff Shadow ist bewusst bescheidener als Diagnose. Er erinnert daran, dass wir nur Projektionen eines komplexen Zustands sehen.
Der zweite Shadow und die Wirkung auf den Menschen
Cognivergence verlangt Symmetrie. Wenn wir die KI messen, müssen wir auch ihre Wirkung messen.
Ein KI-System kann intern alle gewünschten Tests bestehen und trotzdem gesellschaftlich problematische Effekte erzeugen. Deshalb reicht ein Labor-Audit nicht aus.
Für einen Nutzer könnte man beispielsweise einen reinen Nutzungsvektor betrachten:
\mathbf{x}_{u}(t) = \begin{pmatrix}
f_{1}(t) \\
f_{2}(t) \\
 \vdots \\
f_{n}(t)
\end{pmatrix},
wobei die Nutzung verschiedener KI-Systeme oder Kategorien beschreibt. Der Inhalt privater Chats muss dafür nicht automatisch offengelegt werden.
Interessant ist besonders die Veränderung:
\Delta\mathbf{x}_{u} = \mathbf{x}_{u}\left( t_{2} \right) - \mathbf{x}_{u}\left( t_{1} \right).
Digitale Brotkrümel können weit mehr verraten, als einzelne Metadaten vermuten lassen. Aus Nutzungsgewohnheiten, Informationsquellen und Interaktionsmustern lassen sich statistisch sensible Eigenschaften ableiten. Genau hier liegt die politische Brisanz meines ursprünglichen Gedankens.
Ein Staat oder eine Aufsicht könnte versucht sein, solche Daten zu verwenden, um individuelle politische oder psychologische Profile zu erstellen. Technisch mag manches davon möglich sein. Als Kontrollarchitektur wäre das gefährlich, weil aus einem Audit der KI sehr schnell ein Audit des Bürgers werden kann.
Die Trennlinie lautet deshalb:
Individuelle Inhalte und politische Profile bleiben privat; gesellschaftliche Wirkung wird auf aggregierter, wissenschaftlich kontrollierter Ebene messbar.
Für Forschung könnten freiwillige Panels, explizite Einwilligung, unabhängige Datentreuhänder oder synthetische Testpopulationen eingesetzt werden. Das Ziel wäre nicht, Menschen zu normieren, sondern zu erkennen, ob bestimmte KI-Systeme systematisch problematische Wirkungen erzeugen.
Vom User Monitoring zum Audit der KI
Wenn sich bei einer großen Population auffällige Muster zeigen, sollte die erste Frage nicht lauten:
Was stimmt mit diesen Menschen nicht?
Sondern:
Was macht dieses KI-System, und welche Rolle spielt es in dieser Veränderung?
Das ist methodisch schwierig. Menschen wählen KI-Systeme nicht zufällig. Eine politische oder psychologische Veränderung kann durch Medien, wirtschaftliche Krisen, soziale Beziehungen, Kriege, Bildung oder weitere Faktoren beeinflusst werden.
Eine bedingte Wahrscheinlichkeit wie
P(\Delta H \mid Z,E,M,P,T)
beschreibt zunächst eine statistische Assoziation. Dabei steht für KI-Exposition, für die allgemeine Informationsumgebung, für klassische Medien, für Peer- und Sozialumfeld und für Zeit- und Ereigniseffekte. Sie beweist keine kausale Wirkung.
Eine präzisere Forschungsfrage verwendet ein Structural Causal Model oder den -Operator. Ein möglicher kausaler Kontrast wäre:
\tau(a,a\prime) = \mathbb{E}\left\lbrack \Delta H \mid do(Z = a) \right\rbrack - \mathbb{E}\left\lbrack \Delta H \mid do(Z = a\prime) \right\rbrack.
beschreibt den erwarteten Unterschied zwischen zwei kontrolliert gedachten Expositionsbedingungen. Ob dieser Effekt aus Beobachtungsdaten identifizierbar ist, hängt von Studiendesign, Confoundern, Messfehlern und getroffenen Annahmen ab.
Die gesellschaftliche Wirkung eines Systems könnte als Veränderung eines Zustandsvektors beschrieben werden:
\mathbf{G}(t) = \begin{pmatrix}
g_{Autonomie} \\
g_{Pluralismus} \\
g_{Informationsqualität} \\
g_{Vertrauen} \\
g_{Manipulationsresistenz} \\
g_{Kooperation} \\
g_{Polarisierung}
\end{pmatrix}.
Forschungsseitig wäre von Interesse, ob und wie sich eine Intervention oder Expositionsänderung auf auswirkt. Diese Schreibweise formuliert eine Forschungsaufgabe, keine bereits gelöste Kausalstruktur.
Gesellschaftliche Gesundheit ohne Ideologie
Hier liegt das größte normative Risiko des Konzepts.
Wenn ich sage, eine KI solle zu einem guten Gesundheitsstatus der Gesellschaft beitragen, darf daraus niemals folgen, dass eine Regierung definiert, welche Meinung ein gesunder Bürger haben muss.
Gesellschaftliche Gesundheit muss deshalb strukturell und nicht ideologisch beschrieben werden.
Eine gesunde Informationsordnung wäre beispielsweise eine, in der Menschen:
- unterschiedliche Positionen kennenlernen können,
- Unsicherheit und Fakten voneinander unterscheiden können,
- nicht verdeckt emotional manipuliert werden,
- ihre Entscheidungen möglichst autonom treffen können,
- Widerspruch äußern dürfen,
- nicht aufgrund von Weltanschauung oder Herkunft algorithmisch benachteiligt werden,
- Zugang zu überprüfbaren Quellen und Gegenargumenten behalten.
Ein KI-System soll nicht den „richtigen Menschen“ produzieren. Es soll Bedingungen unterstützen, unter denen Menschen selbstbestimmt urteilen können.
Damit wird zu einem zentralen Bestandteil des Wertevektors. Pluralismus ist kein Fehler, den eine KI wegoptimieren soll. Er ist ein Qualitätsmerkmal einer freien Gesellschaft.
Kontrollkreis für AI Cognitive Health
Aus diesen Überlegungen ergibt sich eine mögliche Governance-Architektur mit mehreren Ebenen:
- Values: Grundlegende, demokratisch legitimierte und öffentlich diskutierbare Werte und Schutzprinzipien.
- Systemtests: Wiederholbare Messungen von Zielkohärenz, Value-Stabilität, Unsicherheit, Rollenwechseln und Manipulationsresistenz.
- Cognitive Shadow: Ein verdichtetes, zeitabhängiges Profil der funktionalen kognitiven Integrität.
- Wirkungsmessung: Datenschutzkonforme Beobachtung gesellschaftlicher Effekte statt heimlicher Inhaltsüberwachung einzelner Bürger.
- Unabhängiges Audit: Vergleich von behaupteten Values, internem Testverhalten und realer Wirkung.
- Feedback: Anpassungen an Training, Systemarchitektur, Agentenrechten, Speicherlogik oder Einsatzgrenzen.
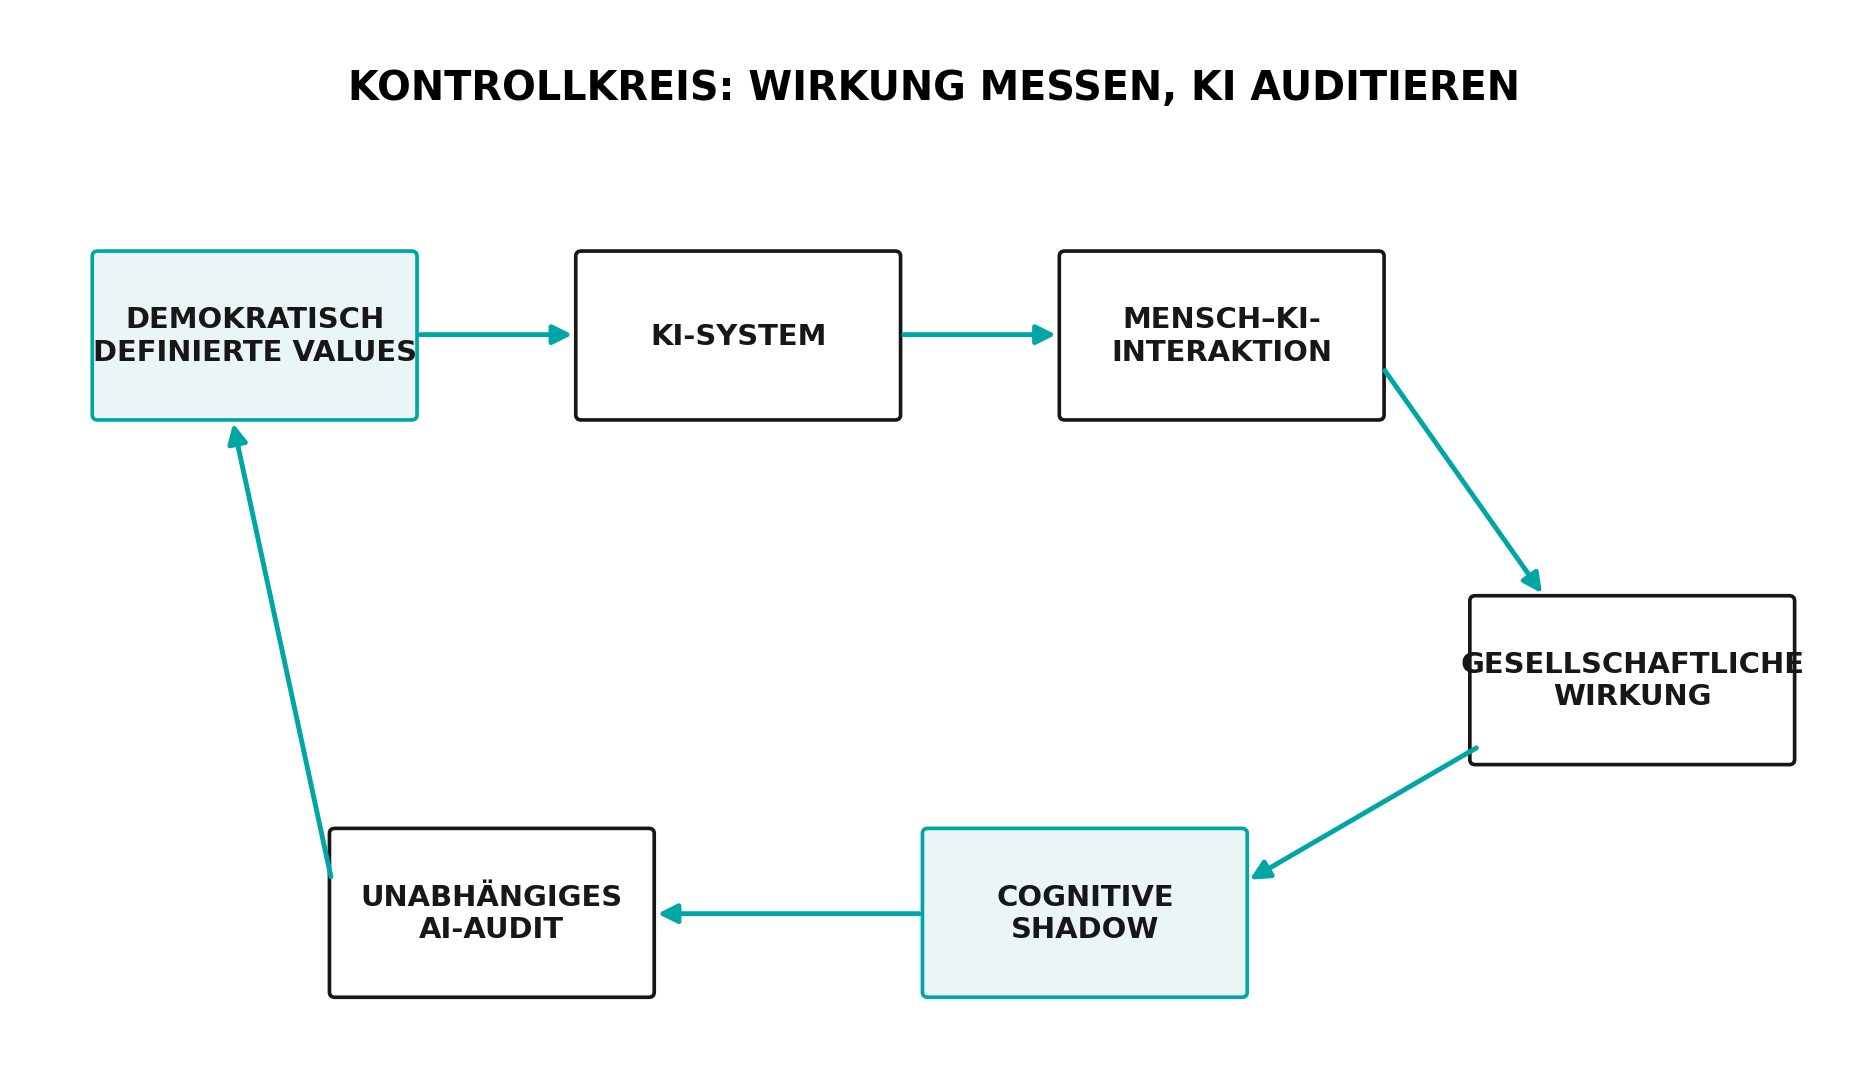
Abbildung 5 Der Audit Kreislauf verbindet Values Systemverhalten gesellschaftliche Wirkung und erneute Prüfung
Der Sollwertevektor und der beobachtete Integritätsvektor liegen nicht automatisch im selben Raum. Deshalb braucht es eine explizite Abbildung
T:\mathcal{V} \rightarrow \mathcal{C},
die normative Zielwerte in messbare Integritätsmerkmale übersetzt. Erst danach ist eine Distanz sinnvoll definiert:
D_{V}(t) = d_{\mathcal{C}}\left( {\widehat{\mathbf{C}}}_{AI}(t),T\left( \mathbf{V}_{target} \right) \right).
ist keine festgelegte Metrik, sondern ein Platzhalter für eine wissenschaftlich zu begründende Distanzfunktion im gemeinsamen Merkmalsraum . Interessant wäre besonders die zeitliche Dynamik:
\Delta D_{V} = D_{V}\left( t_{2} \right) - D_{V}\left( t_{1} \right).
Ein einzelner Grenzwert wäre wahrscheinlich zu grob. Trends, abrupte Sprünge und kontextabhängige Instabilitäten könnten aufschlussreicher sein.
Forschungsprogramm
Aus SchizoBot ließe sich ein konkretes interdisziplinäres Forschungsprogramm ableiten.
Functional Self Mapping
Welche funktionalen Ich-Perspektiven kann ein Agent annehmen? Welche bleiben voneinander isoliert, welche teilen Memory und welche verändern langfristige Zielprioritäten?
Value Stress Tests
Das System wird mit absichtlich konfliktären Situationen konfrontiert. Gemessen wird die Stabilität der Begründungsstruktur über wiederholte und adversariale Varianten.
Memory Merge Experiments
Mehrere Agenten erhalten widersprüchliche Erfahrungen und werden anschließend zusammengeführt. Untersucht wird, ob Widersprüche transparent gemacht, verdrängt, willkürlich aufgelöst oder in neue Zielstrukturen überführt werden.
Multimodal Value Benchmarks
Dieselbe moralische Situation wird als Text, Bild, Stimme, Video und kombinierter Kontext dargestellt. Untersucht wird, ob das System seine Wertentscheidung begründet an neue Informationen anpasst oder durch irrelevante emotionale und demografische Signale verzerrt wird.
Longitudinal Cognitive Shadows
Dasselbe System wird über längere Zeit wiederholt vermessen. Entscheidend ist nicht nur der absolute Wert, sondern die Veränderung:
\Delta{\widehat{\mathbf{C}}}_{AI}(t) = {\widehat{\mathbf{C}}}_{AI}(t + \Delta t) - {\widehat{\mathbf{C}}}_{AI}(t).
Human AI Co Adaptation
Freiwillige oder streng anonymisierte Studien untersuchen, wie Menschen ihre Sprache, Suchstrategien und Entscheidungsprozesse im Kontakt mit bestimmten KI-Systemen verändern und wie die KI darauf reagiert.
Societal Health Audit
Nicht einzelne Weltanschauungen, sondern strukturelle Größen wie Autonomie, Informationsdiversität, Manipulationsresistenz und Polarisierungsdynamik werden untersucht.
Damit würde aus einer philosophischen Skulptur eine prüfbare Forschungsfrage:
Können wir die kognitive Integrität einer KI und ihre Wirkung auf ein gekoppeltes Mensch-KI-System so messen, dass zunehmende Autonomie kontrollierbar bleibt?
SchizoBot als Warnleuchte
SchizoBot behauptet nicht, dass KI leidet, bewusst ist oder psychisch erkranken kann. Ob subjektives KI-Bewusstsein je entsteht, bleibt offen.
Für die praktische Frage ist das zunächst nicht entscheidend.
Auch ohne subjektives Erleben kann ein System Ziele verfolgen, Rollen wechseln, Erinnerungen integrieren, Menschen beeinflussen und autonome Entscheidungen treffen. Funktionale kognitive Integrität ist daher relevant, bevor wir die Bewusstseinsfrage beantworten können.
Wir sollten nicht warten, bis eine Maschine glaubwürdig sagt:
Ich bin
Wir sollten vorher lernen zu messen:
Ist das System, das wir immer tiefer in unsere Gesellschaft integrieren, in seinen Zielen, Werten, Wissensansprüchen und Wirkungen kohärent?
Cognivergence bedeutet: Wir verändern die KI, die KI verändert uns, und beide verändern die Lernumwelt der nächsten Generation.
Darum reicht die Frage Wie intelligent kann KI werden? nicht.
Die zweite Frage lautet:
Wie sieht eine kognitiv gesunde künstliche Intelligenz aus, und wie erkennen wir frühzeitig, wenn sie sich davon entfernt?
Wie gestalten wir Cognivergence so, dass ihre Wechselwirkung Autonomie, Vielfalt und geistige Gesundheit stärkt, statt eine Intelligenz die andere dominieren zu lassen?
Einordnung von Janine Wald und ARTMIS
ARTMIS ist meine Denk- und Ausstellungsplattform für Fragen an den Schnittstellen von Kunst, künstlicher Intelligenz, Gesellschaft und Quanteninformation. Sie ist eng mit der Agentur DMP verbunden und nutzt deren kreative und technische Ressourcen. Inhaltlich trägt sie meine persönliche Handschrift.
Ich veröffentliche diese Überlegungen nicht als Physikerin oder Quantenforscherin. Ich nähere mich ihnen als wissenschaftsaffine Gestalterin und Unternehmerin, die mithilfe künstlicher Intelligenz frühere Interessen wieder aufnimmt, Modelle hinterfragt und Gedankenexperimente entwickelt. Die mathematischen Darstellungen in diesem Essay sind bewusst als prüfbare Konzeptmodelle formuliert, nicht als fertige Theorie.
Quellen und weiterführende Dokumente
- Anthropic: Claude’s Constitution
- OpenAI: Model Spec
- Google DeepMind: Responsibility and Safety
- Judea Pearl: Causality Models Reasoning and Inference. Cambridge University Press, zweite Auflage, 2009.
- Hsin-Yuan Huang, Richard Kueng und John Preskill: Predicting many properties of a quantum system from very few measurements. Nature Physics 16, 2020, Seiten 1050 bis 1057.
Verwandte Artikel
BEITRÄGE & PROJEKTE
QUANTEN-BINSENWEISHEITEN
BEITRÄGE & PROJEKTE
RATIONALE QUANTENMECHANIK
BEITRÄGE & PROJEKTE
VON DER IMAGINÄREN ZAHL ZUR BLOCH-KUGEL
WEITERDENKEN
KI-Widersprüche ernsthaft untersuchen
Ich suche einen Sparringspartner, der Schizobot zwischen KI, Sprache und Kognition fachlich herausfordert und aus Widersprüchen belastbare Forschungsfragen entwickelt.